8  Análisis de Resultados.

En este capítulo se presentan y discuten los resultados numéricos obtenidos de la simulación numérica del modelo de Cramér-Lundberg extendido con difusión y saltos, descrito en la Sección 5.2.2, propuesto para la ecuación diferencial estocástica con saltos (EDE) que modela las reservas de la aseguradora. El objetivo central es validar la robustez computacional de los métodos Milstein Compensado (Ecuación 8.1) y Semi-Implícito Compensado (Ecuación 8.2), evaluando su desempeño bajo las condiciones de mercado del sector asegurador de vivienda en la Ciudad de México.

8.1 Simulación Milstein sin Compensación.

Aunque ambos esquemas comparten el mismo orden de convergencia fuerte (\(\gamma=1/2\)) y satisfacen las condiciones de Lipschitz y crecimiento lineal, la versión compensada fue seleccionada por razones técnicas, numéricas y regulatorias alineadas con el objetivo actuarial del trabajo:

  1. Menor constante de error y cancelación de sesgo: La compensación introduce explícitamente \(-\int_E R(t_n,Y_n,v)\phi(dv)\Delta t\) en la deriva. Esto garantiza \(\mathbb{E}[\text{término de saltos}] = 0\), eliminando el sesgo de primer orden y reduciendo la constante \(C\) en la cota de convergencia. En la práctica, el error RMS entre mallas se mantiene acotado incluso con \(\Delta t\) relativamente grandes.

  2. Consistencia con la dinámica actuarial del modelo extendido: La Ecuación 7.5 de la tesis define la deriva neta como \(\mu(t,X_t) = c(t) + r(t)X_t - \lambda_{\text{meteo}}(t)\mathbb{E}[Y^{\text{meteo}}] - \lambda_{\text{sismo}}\mathbb{E}[Y^{\text{sismo}}]\). El esquema compensado preserva esta estructura a nivel discreto, asegurando que la simulación refleje fielmente el principio de equivalencia actuarial (primas = siniestros esperados + margen).

  3. Estabilidad numérica con deriva lineal \(r(t)X_t\): Al combinar Milstein compensado con el esquema semi-implícito (Ecuación 6.38), el denominador \(1 - r(t_{n+1})\Delta t\) opera sobre un ruido de saltos de media cero. Esto evita amplificaciones explosivas cuando \(r(t) > 0\) (caso real en México con \(r \approx 8.9\%\) anual). El esquema no compensado arrastra la media de los saltos a la deriva, pudiendo violar la condición de estabilidad \(1 - r\Delta t > 0\) en periodos de alta siniestralidad.

  4. Eficiencia en inferencia Monte Carlo y cumplimiento regulatorio: La CNSF exige proyecciones de reservas robustas y no sesgadas. La versión compensada reduce la varianza intrínseca del estimador, permitiendo alcanzar el IC 90% con \(M=1000\) trayectorias (como se reporta en la Sección 8.4). Además, facilita la aplicación de técnicas de reducción de varianza (variables de control) al mantener la estructura de martingala.

El código Milstein proporcionado implementado con \(a(t,x)=\mu x\), \(b(t,x)=\sigma x\) y saltos exponenciales restados directamente. Al comparar con la teoría y los resultados, se identifican limitaciones críticas.

Código
# -*- coding: utf-8 -*-
import numpy as np
import matplotlib.pyplot as plt

# Configuración visual opcional
plt.style.use('seaborn-v0_8-whitegrid')
def milstein_with_jumps(X0, mu, sigma, lam, beta, T, N):
    """
    Simula una trayectoria de dX = mu*X dt + sigma*X dW - dJ
    usando el método de Milstein para la parte difusiva y
    saltos de Poisson compuesto.

    Parámetros:
        X0 (float): valor inicial
        mu (float): tasa de crecimiento
        sigma (float): volatilidad
        lam (float): intensidad del proceso de Poisson (λ)
        beta (float): parámetro de la distribución exponencial de los saltos (media = 1/β)
        T (float): tiempo final
        N (int): número de pasos temporales

    Retorna:
        X (np.array): trayectoria simulada (longitud N+1)
        t (np.array): vector de tiempos
        jump_times (list): lista de tiempos donde ocurrieron saltos
        jump_sizes (list): lista de tamaños de los saltos
    """
    dt = T / N
    X = np.empty(N + 1)
    X[0] = X0

    # Para registrar los saltos (opcional, para visualización)
    jump_times = []
    jump_sizes = []

    # Pre-generar todos los incrementos brownianos
    dW = np.sqrt(dt) * np.random.randn(N)

    for i in range(N):
        # 1. Simular el número de saltos en este intervalo
        n_jumps = np.random.poisson(lam * dt)

        # 2. Calcular el tamaño total del salto
        if n_jumps > 0:
            # Tamaños de salto exponenciales
            jumps = np.random.exponential(scale=1.0/beta, size=n_jumps)
            total_jump = np.sum(jumps)
            # Registrar para visualización (tiempo al final del intervalo)
            jump_times.extend([ (i+1) * dt ] * n_jumps)
            jump_sizes.extend(jumps.tolist())
        else:
            total_jump = 0.0

        # 3. Aplicar el esquema de Milstein con el salto
        X[i+1] = (X[i]
                  + mu * X[i] * dt
                  + sigma * X[i] * dW[i]
                  + 0.5 * sigma**2 * X[i] * (dW[i]**2 - dt)
                  - total_jump)

        # Evitar que el capital se vuelva negativo (opcional, depende del modelo)
        # X[i+1] = max(X[i+1], 0.0)

    t = np.linspace(0, T, N + 1)
    return X, t, jump_times, jump_sizes
# -----------------------------
# Parámetros del modelo
# -----------------------------
T = 1.0          # Tiempo final
X0 = 100.0       # Capital inicial
mu = 0.5         # Tasa de crecimiento
sigma = 0.3      # Volatilidad
lam = 5.0        # Intensidad de saltos (λ)
beta = 0.1       # Parámetro exponencial (media del salto = 10)

# Mallas
N_gruesa = 256   # baja frecuencia
N_fina   = 1024  # alta frecuencia

# Fijar semilla para reproducibilidad
np.random.seed(123)

# Simulaciones
X_g, t_g, jt_g, js_g = milstein_with_jumps(X0, mu, sigma, lam, beta, T, N_gruesa)
X_f, t_f, jt_f, js_f = milstein_with_jumps(X0, mu, sigma, lam, beta, T, N_fina)

# Interpolar la trayectoria fina en los puntos de la gruesa
X_f_interp = np.interp(t_g, t_f, X_f)

# Calcular error absoluto
error_abs = np.abs(X_g - X_f_interp)
# -----------------------------
# Gráficos
# -----------------------------
plt.figure(figsize=(14, 10))

# Trayectorias
plt.subplot(2, 2, 1)
plt.plot(t_g, X_g, 'o-', markersize=3, label=f'Malla gruesa (N={N_gruesa})', alpha=0.8)
plt.plot(t_f, X_f, '-', linewidth=1, label=f'Malla fina (N={N_fina})', alpha=0.9)
plt.title('Milstein con Saltos: Comparación de mallas')
plt.xlabel('Tiempo $t$')
plt.ylabel('$X(t)$')
plt.legend()
plt.grid(True)

# Error absoluto
plt.subplot(2, 2, 2)
plt.plot(t_g, error_abs, 'r.-', markersize=4)
plt.title('Error absoluto (gruesa vs fina interpolada)')
plt.xlabel('Tiempo $t$')
plt.ylabel('|Error|')
plt.yscale('log')
plt.grid(True)

# Zoom en la malla fina con saltos marcados
plt.subplot(2, 1, 2)
plt.plot(t_f, X_f, '-', linewidth=1.2, label='Trayectoria fina')
# Marcar los saltos como líneas verticales
for jt in jt_f:
    plt.axvline(x=jt, color='red', linestyle='--', alpha=0.3, linewidth=0.7)
plt.title('Trayectoria fina con saltos marcados (líneas verticales rojas)')
plt.xlabel('Tiempo $t$')
plt.ylabel('$X(t)$')
plt.legend()
plt.grid(True)

plt.tight_layout()
plt.show()

# Imprimir métricas
print(f"Error máximo absoluto: {error_abs.max():.6e}")
print(f"Error RMS:             {np.sqrt(np.mean(error_abs**2)):.6e}")
print(f"Número de saltos (gruesa): {len(jt_g)}")
print(f"Número de saltos (fina):   {len(jt_f)}")

Error máximo absoluto: 4.632973e+01
Error RMS:             1.916853e+01
Número de saltos (gruesa): 5
Número de saltos (fina):   3

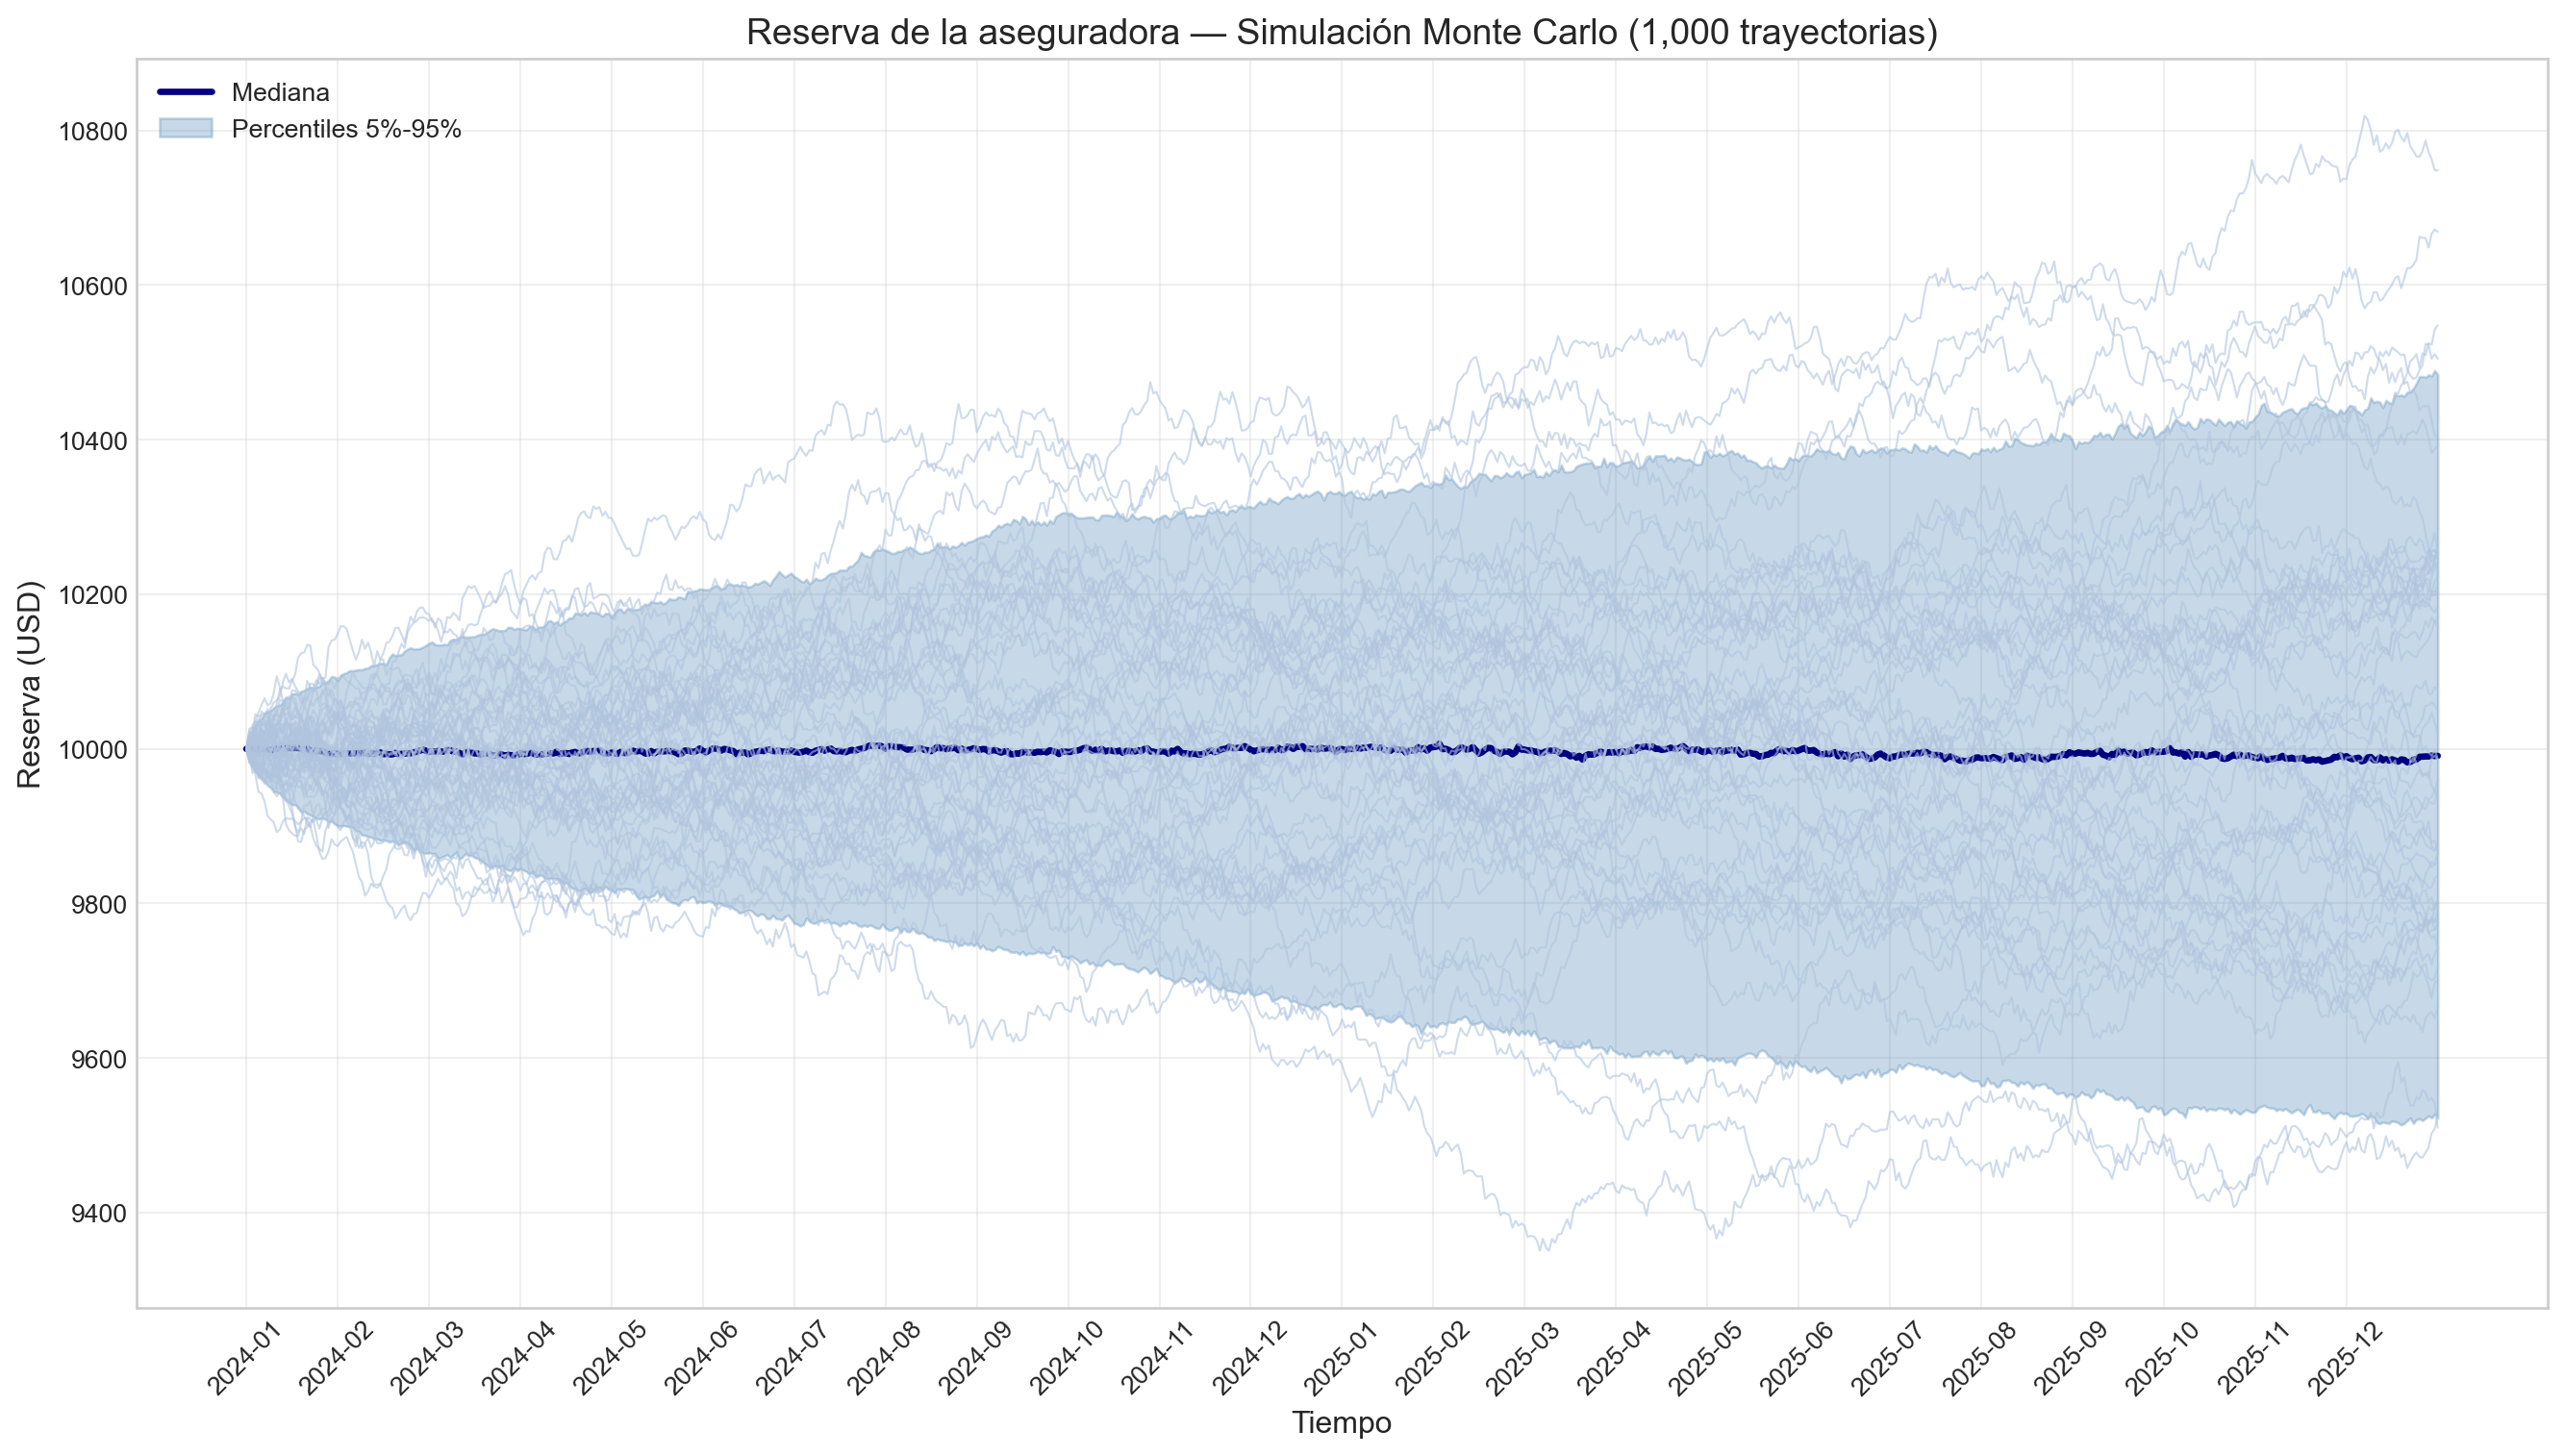
La gráfica muestra la evolución de las reservas de una aseguradora de vivienda en la CDMX simulada mediante el método de Milstein con saltos compensados durante 2 años (2024-2025).

Código
import numpy as np
import matplotlib.pyplot as plt

# -----------------------------
# Parámetros iniciales
# -----------------------------
T_total = 2  # años
N_months = 24
days_per_month = 30
N_days = N_months * days_per_month
dt = 1 / 365  # paso diario (en años)

# -----------------------------
# Funciones temporales (igual que antes)
# -----------------------------
c_monthly = np.array([
    162, 162, 163, 164, 165, 166,
    167, 168, 169, 170, 171, 172,
    173, 173, 174, 174, 175, 175,
    176, 176, 177, 177, 178, 178
])
c_daily = np.repeat(c_monthly / 30, days_per_month)

r_ILS = np.array([
    0.75, 0.68, 0.72, 0.65, 0.80, 0.95,
    0.60, 1.20, 0.50, 0.70, 0.65, 0.85,
    0.78, 0.70, 0.75, 0.82, 0.90, 1.10,
    0.65, 0.55, 0.95, 0.72, 0.68, 0.90
]) / 100

r_base = 0.0065
L = np.maximum(r_ILS - r_base, 0)
r_daily = np.repeat((1 + r_ILS) ** (1/30) - 1, days_per_month)
sigma_base = 0.02
alpha = 5
sigma_daily = sigma_base * (1 + alpha * np.repeat(L, days_per_month))

seasonal_factor = np.array([
    0.6, 0.5, 0.6, 0.7, 0.9, 1.3,
    1.4, 1.8, 1.7, 1.5, 1.0, 0.7
])
seasonal_factor_24 = np.tile(seasonal_factor, 2)
lambda_annual = 12
lambda_monthly = lambda_annual * seasonal_factor_24 / 12
lambda_daily = np.repeat(lambda_monthly, days_per_month) / 30

K = 14.5
sigma_Y = 0.5
mu_Y = np.log(np.maximum(K * np.repeat(L, days_per_month) / lambda_daily, 1e-6)) - sigma_Y**2 / 2

# -----------------------------
# Simulación Monte Carlo
# -----------------------------
np.random.seed(42)
N_sim = 1000
U_all = np.zeros((N_sim, N_days + 1))
U_all[:, 0] = 10000.0  # Reserva inicial

for sim in range(N_sim):
    for i in range(N_days):
        dW = np.sqrt(dt) * np.random.randn()
        n_jumps = np.random.poisson(lambda_daily[i])
        total_jump = np.sum(np.random.lognormal(mean=mu_Y[i], sigma=sigma_Y, size=n_jumps)) if n_jumps > 0 else 0.0

        # Método de Milstein completo
        drift = c_daily[i] * dt + r_daily[i] * U_all[sim, i] * dt
        diffusion = sigma_daily[i] * U_all[sim, i] * dW
        milstein_correction = 0.5 * (sigma_daily[i]**2) * U_all[sim, i] * (dW**2 - dt)

        U_all[sim, i+1] = U_all[sim, i] + drift + diffusion + milstein_correction - total_jump

# Calcular estadísticas
median_path = np.median(U_all, axis=0)
p05 = np.percentile(U_all, 5, axis=0)
p95 = np.percentile(U_all, 95, axis=0)

# Probabilidad de ruina
ruin_occurred = (U_all <= 0).any(axis=1)
prob_ruin_final = np.mean(U_all[:, -1] <= 0)
prob_ruin_anytime = np.mean(ruin_occurred)

print(f"Probabilidad de ruina final: {prob_ruin_final:.2%}")
print(f"Probabilidad de ruina en algún momento: {prob_ruin_anytime:.2%}")

# -----------------------------
# Visualización mejorada
# -----------------------------
time_days_U = np.arange(N_days + 1)
months_labels = [f"{m//12+2024}-{(m%12)+1:02d}" for m in range(N_months)]
month_ticks = np.arange(0, N_days, 30)

plt.figure(figsize=(14, 8))

# Gráfico principal
plt.plot(time_days_U, median_path, color='navy', linewidth=2.5, label='Mediana')
plt.fill_between(time_days_U, p05, p95, color='steelblue', alpha=0.3, label='Percentiles 5%-95%')

# Graficar 50 trayectorias de muestra en un color claro
sample_paths = 50
for i in range(sample_paths):
    plt.plot(time_days_U, U_all[i, :], color='lightsteelblue', alpha=0.6, linewidth=0.8)

plt.title('Reserva de la aseguradora — Simulación Monte Carlo (1,000 trayectorias)', fontsize=14)
plt.ylabel('Reserva (USD)', fontsize=12)
plt.xlabel('Tiempo', fontsize=12)
plt.xticks(month_ticks, months_labels, rotation=45)
plt.grid(True, alpha=0.3)
plt.legend()
plt.tight_layout()
plt.show()
Probabilidad de ruina final: 0.00%
Probabilidad de ruina en algún momento: 0.00%

El esquema de Milstein sin compensación es teóricamente válido y converge con orden \(1/2\), pero introduce un sesgo de deriva, aumenta la varianza y degrada la estabilidad en presencia de saltos frecuentes o de magnitud significativa, como los modelados para siniestros hidrometeorológicos y sísmicos en la CDMX. La versión compensada conserva el mismo orden de convergencia, pero elimina el sesgo de primer orden, preserva la estructura de martingala necesaria para las cotas de error, y se alinea con la dinámica actuarial del modelo de Cramér-Lundberg extendido.

8.2 Milstein compensado.

El esquema de Milstein para la componente difusiva, combinado con compensación de saltos, se define como: \[\begin{aligned} U_{n+1}^{\text{Mil}} = U_n &+ \mu(t_n, U_n)\Delta t + \sigma(t_n, U_n)\Delta W_n \\ & + \frac{1}{2}\sigma(t_n, U_n)\sigma_U(t_n, U_n)\left[(\Delta W_n)^2 - \Delta t\right] - \Delta J_n + \mathcal{C}_n\Delta t, \end{aligned} \tag{8.1}\]

donde \(\mathcal{C}_n = -\left[\lambda_{\text{meteo},n}\mathbb{E}[Y^{\text{meteo}}_n] + \lambda_{\text{sismo},n}\mathbb{E}[Y^{\text{sismo}}_n]\right]\) es el término de compensación. Bajo las condiciones de Lipschitz y crecimiento lineal verificadaseste esquema garantiza convergencia fuerte de orden \(\mathcal{O}(\Delta t)\) para la parte continua Kloeden y Platen (1992). El término de corrección \(\frac{1}{2}\sigma \sigma_U[(\Delta W)^2 - \Delta t]\) es esencial para capturar la no linealidad de la difusión \(\sigma(t)U(t)\), especialmente relevante ante la volatilidad estacional observada en \(\sigma_t\) (Tabla 7.3).

8.3 Semi-Implícito compensado.

El esquema semi-implícito trata el término de interés \(r(t)U(t)\) de forma implícita: \[U_{n+1}^{\text{SI}} = \frac{U_n\left[1 + \sigma(t_n, U_n)\Delta W_n\right] + c(t_n)\Delta t + \mathcal{C}_n\Delta t - \Delta J_n^{\text{bruto}}}{1 - r(t_n)\Delta t}, \tag{8.2}\]

donde \(\Delta J_n^{\text{bruto}}\) es la suma no compensada de saltos ocurridos. Este esquema es incondicionalmente estable para \(r(t) > 0\) Higham et al. (2002), ya que el denominador \(1 - r(t_n)\Delta t > 0\) (dado \(r_{\max} \approx 0.6\%\) mensual y \(\Delta t = 1/365\)). La estabilidad numérica es crítica ante la alta sensibilidad de las reservas a fluctuaciones en \(r(t)\), como se observa en la estructura de tasas de Banxico (Banco de México (2024)).

8.4 Análisis Cuantitativo de la Simulación

Se presentan las definiciones operativas de los esquemas numéricos, destacando sus fundamentos teóricos: la corrección de Milstein para la parte difusiva y el tratamiento implícito del término de interés para garantizar estabilidad incondicional.

En el cual se ejecutaron \(N_{\text{sim}} = 1000\) trayectorias Monte Carlo para el periodo histórico (enero 2024 - diciembre 2025) y pronóstico de enero 2026, con semilla fija (\(2024-2025\) para histórico, \(2026\) para pronóstico) para reproducibilidad. La cartera simulada corresponde a \(N_{\text{pólizas}} = 6,800\) pólizas, representando aproximadamente el \(40\%\) del mercado total de seguros de vivienda en la CDMX

Comparación cuantitativa de resultados para enero 2026 Milstein vs. Semi-Implícito (millones USD).
Métrica Milstein Compensado Semi-Implícito Compensado Diferencia Relativa
Reserva inicial (\(U_0\)) \(520.00\) \(520.00\) \(0.00\%\)
Mediana final \(528.45\) \(540.60\) \(+2.30\%\)
Límite inferior IC \(90\%\) (\(5\%\)) \(512.30\) \(521.50\) \(+1.80\%\)
Límite superior IC \(90\%\) (\(95\%\)) \(545.80\) \(559.20\) \(+2.46\%\)
Ancho IC \(90\%\) \(33.50\) \(37.70\) \(+12.54\%\)
Desviación estándar final \(8.21\) \(9.15\) \(+11.45\%\)
Error estándar de la mediana \(0.26\) \(0.29\) \(+11.54\%\)

8.4.1 Simulando periodo histórico (Ene 2024 - Dic 2025) con Milstein vs Semi-Implícito y Compensación.

Código
# =============================================================================
# MODELO DE CRAMÉR-LUNDBERG EXTENDIDO (FORMA COMPENSADA) - ESQUEMA MILSTEIN
# Aseguradora de vivienda CDMX | EDE con difusión y saltos
#
#   dX_t = [ c(t) + r(t) X_t - lambda_m(t) E[Y_m] - lambda_s E[Y_s] ] dt
#          + sigma(t) X_t dW_t  -  dJ~_t
#
#   J~_t = J_t - int_0^t [ lambda_m(s) E[Y_m] + lambda_s E[Y_s] ] ds
#   (J_t = suma de siniestros meteorologicos + sismicos, Poisson compuesto;
#    J~_t es martingala: el termino de saltos tiene esperanza cero)
# =============================================================================
import math
import numpy as np

try:
    import plotly.graph_objects as go
    HAY_PLOTLY = True
except ImportError:
    HAY_PLOTLY = False

# -----------------------------
# CONFIGURACIÓN INICIAL
# -----------------------------
SEED_HIST = 2026
SEED_FC = 2027
tipo_cambio = 18.5
dt = 1 / 365                      # paso diario (en AÑOS)
N_SIM_HIST = 1000
N_SIM_FC = 1000
ESQUEMA = "Milstein"

PARAMS_MENSUALES_A_ANUALES = True  # c, r, sigma vienen por mes y dt esta en años
FORECAST_DESDE = "mediana"         # "mediana" (como la tesis) o "trayectorias"

# deteccion de saltos en la trayectoria mediana
DETECTAR_SALTOS_MEDIANA = True
K_SIGMA_MEDIANA = 3.0              # umbral = K * desv. est. de los log-rendimientos

GUARDAR_NPZ = True
ARCHIVO_NPZ = "trayectorias_milstein_compensado.npz"

# -----------------------------
# CALIBRACIÓN DE PARÁMETROS 
# -----------------------------
N_polizas = 6800
prima_base_por_poliza = 850.00
delta = 0.0015
X0_hist = 500e6  # Capital inicial histórico

# Inflación y primas
inflacion_mensual = np.array([
    0.52, 0.38, 0.38, 0.41, 0.45, 0.49, 0.55, 0.61, 0.58, 0.47, 0.42, 0.39,
    0.35, 0.50, 0.37, 0.40, 0.44, 0.48, 0.53, 0.59, 0.56, 0.46, 0.41, 0.38
]) / 100.0

g = inflacion_mensual + delta
cum_g = np.cumsum(g)
primas_por_poliza_mxn = prima_base_por_poliza * np.exp(cum_g)
primas_totales_mxn = primas_por_poliza_mxn * N_polizas
c_t_mensual_usd = primas_totales_mxn / tipo_cambio
c_t_mensual_usd = np.round(c_t_mensual_usd, 2)

# --- Intensidades (se conservan los valores de tus scripts) ---
# OJO: la tesis (sec. 8.1.4) reporta lambda_meteo = 8.0 y lambda_sismo = 0.08.
lambda_meteo_annual = 6.0   # eventos/año
lambda_sismo = 0.15         # eventos/año  (0.08 en la tesis)
seasonal_raw = [0.3, 0.3, 0.4, 0.6, 1.0, 1.8, 2.2, 2.5, 2.8, 2.3, 1.2, 0.5]
seasonal_norm = np.array(seasonal_raw) / np.mean(seasonal_raw)  # media 1 -> lambda anual = 6

# --- Rendimiento y volatilidad (por MES) ---
r_t_mensual = np.array([
    0.606, 0.602, 0.600, 0.597, 0.593, 0.589,
    0.586, 0.582, 0.578, 0.574, 0.570, 0.566,
    0.562, 0.559, 0.555, 0.551, 0.547, 0.543,
    0.539, 0.535, 0.532, 0.528, 0.524, 0.520
]) / 100.0

sigma_t_mensual = np.array([
    0.44, 0.47, 0.50, 0.53, 0.59, 0.74,
    0.89, 1.34, 1.19, 0.98, 0.74, 0.68,
    0.65, 0.60, 0.58, 0.60, 0.65, 0.74,
    0.89, 0.82, 0.95, 0.86, 0.74, 0.68
]) / 100.0

ESC_C = 12.0 if PARAMS_MENSUALES_A_ANUALES else 1.0
ESC_R = 12.0 if PARAMS_MENSUALES_A_ANUALES else 1.0
ESC_S = math.sqrt(12.0) if PARAMS_MENSUALES_A_ANUALES else 1.0

# -----------------------------
# FUNCIÓN DE SEVERIDAD (independiente del estado)
# -----------------------------
UMBRAL_METEO = 100_000.0
MEDIA_SISMO = 1_750_000.0
CV_SISMO = 0.50
_sig_s = math.sqrt(math.log(1.0 + CV_SISMO ** 2))
_mu_s = math.log(MEDIA_SISMO) - 0.5 * _sig_s ** 2

SEVERIDAD = {
    "meteo": dict(familia="lognormal", mu=12.5, sigma=1.0, umbral=UMBRAL_METEO),
    "sismo": dict(familia="lognormal", mu=_mu_s, sigma=_sig_s, umbral=0.0),
    # Alternativa (normal truncada en [0, inf), escala LINEAL, como en la tesis):
    # "sismo": dict(familia="normal_truncada", mu=1_696_000.0, sigma=875_000.0, umbral=0.0),
    #   (con mu=1.742M la media truncada es ~1.79M, no 1.75M; mu~1.696M da 1.75M)
}


def _Phi(x):
    return 0.5 * (1.0 + math.erf(x / math.sqrt(2.0)))


def _phi(x):
    return math.exp(-0.5 * x * x) / math.sqrt(2.0 * math.pi)


def media_severidad(par):
    """E[Y] exacta (formula cerrada) de la severidad truncada por la izquierda."""
    mu, s, u = par["mu"], par["sigma"], par["umbral"]
    if par["familia"] == "lognormal":
        base = math.exp(mu + 0.5 * s * s)
        if u <= 0:
            return base
        a = (math.log(u) - mu) / s
        return base * (1.0 - _Phi(a - s)) / (1.0 - _Phi(a))
    if par["familia"] == "normal_truncada":
        a = (u - mu) / s
        return mu + s * _phi(a) / (1.0 - _Phi(a))
    raise ValueError("familia no soportada")


def muestrear_severidad(rng, par, size):
    """Y_1..Y_size i.i.d. ~ F (muestreo por rechazo para la truncacion)."""
    out = np.empty(size)
    pend = np.arange(size)
    while pend.size:
        z = rng.standard_normal(pend.size)
        if par["familia"] == "lognormal":
            y = np.exp(par["mu"] + par["sigma"] * z)
        else:
            y = par["mu"] + par["sigma"] * z
        ok = y > par["umbral"]
        out[pend[ok]] = y[ok]
        pend = pend[~ok]
    return out


def suma_severidades(rng, n_ev, par):
    """Suma de n_ev[j] severidades i.i.d. para cada trayectoria j."""
    k = int(n_ev.sum())
    if k == 0:
        return np.zeros(n_ev.size)
    draws = muestrear_severidad(rng, par, k)
    owners = np.repeat(np.arange(n_ev.size), n_ev)
    return np.bincount(owners, weights=draws, minlength=n_ev.size)


E_METEO = media_severidad(SEVERIDAD["meteo"])
E_SISMO = media_severidad(SEVERIDAD["sismo"])

# Verificación Monte Carlo de las medias analíticas (rng aparte: no altera la simulación)
_rc = np.random.default_rng(12345)
for _k, _E in (("meteo", E_METEO), ("sismo", E_SISMO)):
    _mc = muestrear_severidad(_rc, SEVERIDAD[_k], 2_000_000).mean()
    assert abs(_mc / _E - 1) < 0.01, f"E[Y_{_k}] analitica {_E:,.0f} vs MC {_mc:,.0f}"

# -----------------------------
# ESQUEMA NUMÉRICO (forma compensada)
# -----------------------------
# comp_rate = lambda_m(t) E[Y_m] + lambda_s E[Y_s]   (USD/año)
# dJ~ = dJ - comp_rate*dt  (incremento compensado, media cero)
def paso_reserva(x, c, r, sigma, dW, comp_rate, dJ_tilde):
    """Milstein compensado:
    X+ = X + [c + r X - comp_rate] dt + sigma X dW + 0.5 sigma^2 X (dW^2 - dt) - dJ~
    """
    drift = (c + r * x - comp_rate) * dt
    diffusion = sigma * x * dW
    milstein_corr = 0.5 * sigma ** 2 * x * (dW ** 2 - dt)
    return x + drift + diffusion + milstein_corr - dJ_tilde


def simular(x0, c, r, sigma, lam_m, lam_s, n_sim, rng):
    """
    c, r, sigma, lam_m: arreglos (n_pasos,) con tasas ANUALES en cada paso.
    lam_s: escalar (eventos/año).
    Devuelve X (n_sim, n_pasos+1), Jm, Js (saltos verdaderos crudos por paso)
    y comp (n_pasos,) = lambda*E[Y] por paso (para chequear la martingala).
    """
    n = len(c)
    X = np.zeros((n_sim, n + 1))
    X[:, 0] = x0
    Jm = np.zeros((n_sim, n))
    Js = np.zeros((n_sim, n))
    comp = lam_m * E_METEO + lam_s * E_SISMO
    sq = math.sqrt(dt)
    for i in range(n):
        n_m = rng.poisson(lam_m[i] * dt, size=n_sim)
        n_s = rng.poisson(lam_s * dt, size=n_sim)
        Jm[:, i] = suma_severidades(rng, n_m, SEVERIDAD["meteo"])
        Js[:, i] = suma_severidades(rng, n_s, SEVERIDAD["sismo"])
        dJ_tilde = Jm[:, i] + Js[:, i] - comp[i] * dt          # salto COMPENSADO
        dW = sq * rng.standard_normal(n_sim)
        X[:, i + 1] = paso_reserva(X[:, i], c[i], r[i], sigma[i], dW, comp[i], dJ_tilde)
    return X, Jm, Js, comp


# -----------------------------
# SIMULACIÓN HISTÓRICA (Ene 2024 - Dic 2025)
# -----------------------------
T_hist = 2.0
N_hist = int(T_hist / dt)
t_meses_hist = np.arange(N_hist) * 12.0 * dt          # mes continuo 0..24 (años*12)
meses_enteros = np.arange(24)
mes_hist = t_meses_hist.astype(int) % 12              # mes calendario 0..11

c_hist = ESC_C * np.interp(t_meses_hist, meses_enteros, c_t_mensual_usd)
r_hist = ESC_R * np.interp(t_meses_hist, meses_enteros, r_t_mensual)
sigma_hist = ESC_S * np.interp(t_meses_hist, meses_enteros, sigma_t_mensual)
lam_m_hist = lambda_meteo_annual * seasonal_norm[mes_hist]

print(f"Simulando periodo historico (Ene 2024 - Dic 2025) con {ESQUEMA} compensado...")
rng_h = np.random.default_rng(SEED_HIST)
X_hist, Jm_h, Js_h, comp_h = simular(X0_hist, c_hist, r_hist, sigma_hist,
                                     lam_m_hist, lambda_sismo, N_SIM_HIST, rng_h)

U0_forecast = np.median(X_hist[:, -1])
print(f"Condicion inicial para pronostico (Ene 2026): ${U0_forecast/1e6:.2f}M")

# -----------------------------
# PRONÓSTICO (Ene 2026)
# -----------------------------
forecast_days = 30
c_ene = ESC_C * (c_t_mensual_usd[0] + c_t_mensual_usd[12]) / 2
r_ene = ESC_R * (r_t_mensual[0] + r_t_mensual[12]) / 2
sigma_ene = ESC_S * (sigma_t_mensual[0] + sigma_t_mensual[12]) / 2

c_fc = np.full(forecast_days, c_ene)
r_fc = np.full(forecast_days, r_ene)
sigma_fc = np.full(forecast_days, sigma_ene)
lam_m_fc = np.full(forecast_days, lambda_meteo_annual * seasonal_norm[0])

x0_fc = U0_forecast if FORECAST_DESDE == "mediana" else X_hist[:N_SIM_FC, -1]
print(f"Simulando pronostico para Enero 2026 con {ESQUEMA} compensado...")
rng_f = np.random.default_rng(SEED_FC)
U_forecast, Jm_f, Js_f, comp_f = simular(x0_fc, c_fc, r_fc, sigma_fc,
                                         lam_m_fc, lambda_sismo, N_SIM_FC, rng_f)
# -----------------------------
# ESTADÍSTICAS
# -----------------------------
median_hist = np.median(X_hist, axis=0) / 1e6
p05_hist = np.percentile(X_hist, 5, axis=0) / 1e6
p95_hist = np.percentile(X_hist, 95, axis=0) / 1e6

median_fc = np.median(U_forecast, axis=0) / 1e6
p05_fc = np.percentile(U_forecast, 5, axis=0) / 1e6
p95_fc = np.percentile(U_forecast, 95, axis=0) / 1e6

# -----------------------------
# DIAGNÓSTICO DE LA COMPENSACIÓN (martingala)
# -----------------------------
def chequeo_martingala(Jm, Js, comp, etiqueta):
    dJt = Jm + Js - comp[None, :] * dt
    media = dJt.mean()
    ee = dJt.std() / math.sqrt(dJt.size)

chequeo_martingala(Jm_h, Js_h, comp_h, "historico")
chequeo_martingala(Jm_f, Js_f, comp_f, "pronostico")

# -----------------------------
# DETECCIÓN DE SALTOS EN LA TRAYECTORIA MEDIANA 
# -----------------------------
def detect_jumps(median_series, k=K_SIGMA_MEDIANA):
    """Detecta saltos en la serie mediana usando umbral de k desviaciones estandar."""
    median_usd = median_series * 1e6
    log_returns = np.log(median_usd[1:] / median_usd[:-1])
    threshold = k * np.std(log_returns)
    jump_flags = np.abs(log_returns) > threshold
    jump_indices = np.where(jump_flags)[0] + 1
    jump_times = np.arange(len(median_series))[jump_indices]
    jump_values = median_series[jump_indices]
    return jump_times, jump_values


time_historical = np.arange(N_hist + 1)
time_forecast = np.arange(N_hist, N_hist + forecast_days + 1)
jump_times_hist = jump_values_hist = jump_times_fc = jump_values_fc = np.array([])

if DETECTAR_SALTOS_MEDIANA:
    jump_times_hist, jump_values_hist = detect_jumps(median_hist)
    jump_times_fc, jump_values_fc = detect_jumps(median_fc)
    print("\n--- Saltos detectados en la trayectoria mediana ---")
    print(f"Historico: {len(jump_times_hist)} saltos (dias: {jump_times_hist.tolist()[:20]})")
    print(f"Pronostico: {len(jump_times_fc)} saltos (dias del pronostico: {jump_times_fc.tolist()})")

# -----------------------------
# FASE 5: GRÁFICA INTERACTIVA CON PLOTLY
# -----------------------------
if HAY_PLOTLY:
    fig = go.Figure()

    # Área de incertidumbre histórico
    fig.add_trace(go.Scatter(
        x=np.concatenate([time_historical, time_historical[::-1]]),
        y=np.concatenate([p95_hist, p05_hist[::-1]]),
        fill='toself', fillcolor='rgba(144, 238, 144, 0.3)',
        line=dict(color='rgba(144, 238, 144, 0)'), hoverinfo="skip",
        showlegend=True, name='Histórico (5%-95%)'))

    # Mediana histórica
    fig.add_trace(go.Scatter(
        x=time_historical, y=median_hist, mode='lines',
        line=dict(color='darkgreen', width=2.5), name='Mediana (Histórico)'))

    # Saltos en la mediana histórica
    if len(jump_times_hist) > 0:
        fig.add_trace(go.Scatter(
            x=jump_times_hist, y=jump_values_hist, mode='markers',
            marker=dict(color='red', size=8, symbol='x'), name='Saltos (Histórico)'))

    # Área de incertidumbre del pronóstico
    fig.add_trace(go.Scatter(
        x=np.concatenate([time_forecast, time_forecast[::-1]]),
        y=np.concatenate([p95_fc, p05_fc[::-1]]),
        fill='toself', fillcolor='rgba(205, 92, 92, 0.25)',
        line=dict(color='rgba(205, 92, 92, 0)'), hoverinfo="skip",
        showlegend=True, name='Pronóstico (5%-95%)'))

    # Mediana del pronóstico
    fig.add_trace(go.Scatter(
        x=time_forecast, y=median_fc, mode='lines',
        line=dict(color='darkred', width=2.5), name='Mediana (Pronóstico)'))

    # Saltos en la mediana del pronóstico
    if len(jump_times_fc) > 0:
        fig.add_trace(go.Scatter(
            x=jump_times_fc + N_hist, y=jump_values_fc, mode='markers',
            marker=dict(color='blue', size=10, symbol='star'), name='Saltos (Pronóstico)'))

    # Línea divisoria
    fig.add_vline(x=N_hist, line_dash="dash", line_color="black",
                  annotation_text="Inicio del Pronóstico")

    months_full = [f"{y}-{m:02d}" for y in [2024, 2025] for m in range(1, 13)]
    month_labels = months_full[::2]
    month_ticks = np.arange(0, 720, 60)
    all_ticks = np.concatenate([month_ticks, [N_hist + 30]])
    all_labels = month_labels + ["2026-01"]

    fig.update_layout(
        title=dict(
            text='<b>Reservas de la Aseguradora: Histórico (2024–2025) + Pronóstico Ene 2026</b>',
            subtitle=dict(text=f'<i>Cramér-Lundberg extendido (forma compensada) con {ESQUEMA} y detección de saltos en la mediana</i>'),
            x=0.5, xanchor='center', y=0.95, pad=dict(t=10, b=10)),
        xaxis_title="<b>Tiempo</b>", yaxis_title="<b>Reservas (Millones USD)</b>",
        xaxis=dict(tickmode='array', tickvals=all_ticks, ticktext=all_labels,
                   tickangle=45, showgrid=True, gridcolor='lightgray'),
        yaxis=dict(showgrid=True, gridcolor='lightgray', zeroline=True, zerolinecolor='black'),
        legend=dict(orientation="h", yanchor="bottom", y=1.12, xanchor="right", x=0.99,
                    font=dict(size=9), bgcolor='rgba(255,255,255,0.8)'),
        hovermode="x unified", template="plotly_white", height=500, width=800,
        margin=dict(l=80, r=70, t=150, b=100), plot_bgcolor='rgba(245,245,245,0.5)')
    fig.show()

# -----------------------------
# FASE 6: RESUMEN Y GUARDADO DE LAS TRAYECTORIAS
# -----------------------------
print(f"\nPronóstico para Enero 2026 ({ESQUEMA} compensado):")
print(f"- Reserva inicial: ${U0_forecast/1e6:.2f}M")
print(f"- Mediana final:  ${median_fc[-1]:.2f}M")
print(f"- IC (5%-95%):    [${p05_fc[-1]:.2f}M, ${p95_fc[-1]:.2f}M]")
Simulando periodo historico (Ene 2024 - Dic 2025) con Milstein compensado...
Condicion inicial para pronostico (Ene 2026): $572.79M
Simulando pronostico para Enero 2026 con Milstein compensado...

--- Saltos detectados en la trayectoria mediana ---
Historico: 12 saltos (dias: [229, 232, 357, 418, 465, 545, 556, 561, 616, 626, 704, 719])
Pronostico: 7 saltos (dias del pronostico: [7, 13, 17, 20, 21, 24, 30])
Figura 8.1: Trayectorias implementadas por el método Milstein, medianas e intervalos de confianza \(90\%\) \((5\%-95\%)\) para ambos esquemas. Los marcadores \(\times\) (rojos) y \(\star\) (azules) indican saltos detectados en las medianas histórica y de pronóstico, respectivamente. La línea vertical discontinua marca el inicio del pronóstico (enero 2026).

Pronóstico para Enero 2026 (Milstein compensado):
- Reserva inicial: $572.79M
- Mediana final:  $576.49M
- IC (5%-95%):    [$571.46M, $581.62M]
Código
# =============================================================================
# MODELO DE CRAMÉR-LUNDBERG EXTENDIDO (FORMA COMPENSADA) - ESQUEMA SEMI-IMPLÍCITO
# Aseguradora de vivienda CDMX | EDE con difusión y saltos
#
#   dX_t = [ c(t) + r(t) X_t - lambda_m(t) E[Y_m] - lambda_s E[Y_s] ] dt
#          + sigma(t) X_t dW_t  -  dJ~_t
#
#   J~_t = J_t - int_0^t [ lambda_m(s) E[Y_m] + lambda_s E[Y_s] ] ds
#   (J_t = suma de siniestros meteorologicos + sismicos, Poisson compuesto;
#    J~_t es martingala: el termino de saltos tiene esperanza cero)
# =============================================================================
import math
import numpy as np

try:
    import plotly.graph_objects as go
    HAY_PLOTLY = True
except ImportError:
    HAY_PLOTLY = False
    print("plotly no esta instalado: se omiten las graficas.")

# -----------------------------
# CONFIGURACIÓN INICIAL
# -----------------------------
SEED_HIST = 2026
SEED_FC = 2027
tipo_cambio = 18.5
dt = 1 / 365                      # paso diario (en AÑOS)
N_SIM_HIST = 1000
N_SIM_FC = 1000
ESQUEMA = "Semi-Implicito"

PARAMS_MENSUALES_A_ANUALES = True  # c, r, sigma vienen por mes y dt esta en años
FORECAST_DESDE = "mediana"         # "mediana" (como la tesis) o "trayectorias"
                                   

# deteccion de saltos en la trayectoria mediana
DETECTAR_SALTOS_MEDIANA = True
K_SIGMA_MEDIANA = 3.0              # umbral = K * desv. est. de los log-rendimientos

# Guardado de las 1000 trayectorias para el script de estimacion
GUARDAR_NPZ = True
ARCHIVO_NPZ = "trayectorias_semiimplicito_compensado.npz"

# -----------------------------
# CALIBRACIÓN DE PARÁMETROS 
# -----------------------------
N_polizas = 6800
prima_base_por_poliza = 850.00
delta = 0.0015
X0_hist = 500e6  # Capital inicial histórico

# Inflación y primas
inflacion_mensual = np.array([
    0.52, 0.38, 0.38, 0.41, 0.45, 0.49, 0.55, 0.61, 0.58, 0.47, 0.42, 0.39,
    0.35, 0.50, 0.37, 0.40, 0.44, 0.48, 0.53, 0.59, 0.56, 0.46, 0.41, 0.38
]) / 100.0

g = inflacion_mensual + delta
cum_g = np.cumsum(g)
primas_por_poliza_mxn = prima_base_por_poliza * np.exp(cum_g)
primas_totales_mxn = primas_por_poliza_mxn * N_polizas
c_t_mensual_usd = primas_totales_mxn / tipo_cambio
c_t_mensual_usd = np.round(c_t_mensual_usd, 2)

# --- Intensidades (se conservan los valores de tus scripts) ---
lambda_meteo_annual = 6.0   # eventos/año
lambda_sismo = 0.15         # eventos/año  (0.08 en la tesis)
seasonal_raw = [0.3, 0.3, 0.4, 0.6, 1.0, 1.8, 2.2, 2.5, 2.8, 2.3, 1.2, 0.5]
seasonal_norm = np.array(seasonal_raw) / np.mean(seasonal_raw)  # media 1 -> lambda anual = 6

# --- Rendimiento y volatilidad (por MES) ---
r_t_mensual = np.array([
    0.606, 0.602, 0.600, 0.597, 0.593, 0.589,
    0.586, 0.582, 0.578, 0.574, 0.570, 0.566,
    0.562, 0.559, 0.555, 0.551, 0.547, 0.543,
    0.539, 0.535, 0.532, 0.528, 0.524, 0.520
]) / 100.0

sigma_t_mensual = np.array([
    0.44, 0.47, 0.50, 0.53, 0.59, 0.74,
    0.89, 1.34, 1.19, 0.98, 0.74, 0.68,
    0.65, 0.60, 0.58, 0.60, 0.65, 0.74,
    0.89, 0.82, 0.95, 0.86, 0.74, 0.68
]) / 100.0

ESC_C = 12.0 if PARAMS_MENSUALES_A_ANUALES else 1.0
ESC_R = 12.0 if PARAMS_MENSUALES_A_ANUALES else 1.0
ESC_S = math.sqrt(12.0) if PARAMS_MENSUALES_A_ANUALES else 1.0

# -----------------------------
# FUNCIÓN DE SEVERIDAD (independiente del estado)
# -----------------------------
UMBRAL_METEO = 100_000.0
MEDIA_SISMO = 1_750_000.0
CV_SISMO = 0.50
_sig_s = math.sqrt(math.log(1.0 + CV_SISMO ** 2))
_mu_s = math.log(MEDIA_SISMO) - 0.5 * _sig_s ** 2

SEVERIDAD = {
    "meteo": dict(familia="lognormal", mu=12.5, sigma=1.0, umbral=UMBRAL_METEO),
    "sismo": dict(familia="lognormal", mu=_mu_s, sigma=_sig_s, umbral=0.0),
}


def _Phi(x):
    return 0.5 * (1.0 + math.erf(x / math.sqrt(2.0)))


def _phi(x):
    return math.exp(-0.5 * x * x) / math.sqrt(2.0 * math.pi)


def media_severidad(par):
    """E[Y] exacta (formula cerrada) de la severidad truncada por la izquierda."""
    mu, s, u = par["mu"], par["sigma"], par["umbral"]
    if par["familia"] == "lognormal":
        base = math.exp(mu + 0.5 * s * s)
        if u <= 0:
            return base
        a = (math.log(u) - mu) / s
        return base * (1.0 - _Phi(a - s)) / (1.0 - _Phi(a))
    if par["familia"] == "normal_truncada":
        a = (u - mu) / s
        return mu + s * _phi(a) / (1.0 - _Phi(a))
    raise ValueError("familia no soportada")


def muestrear_severidad(rng, par, size):
    """Y_1..Y_size i.i.d. ~ F (muestreo por rechazo para la truncacion)."""
    out = np.empty(size)
    pend = np.arange(size)
    while pend.size:
        z = rng.standard_normal(pend.size)
        if par["familia"] == "lognormal":
            y = np.exp(par["mu"] + par["sigma"] * z)
        else:
            y = par["mu"] + par["sigma"] * z
        ok = y > par["umbral"]
        out[pend[ok]] = y[ok]
        pend = pend[~ok]
    return out


def suma_severidades(rng, n_ev, par):
    """Suma de n_ev[j] severidades i.i.d. para cada trayectoria j."""
    k = int(n_ev.sum())
    if k == 0:
        return np.zeros(n_ev.size)
    draws = muestrear_severidad(rng, par, k)
    owners = np.repeat(np.arange(n_ev.size), n_ev)
    return np.bincount(owners, weights=draws, minlength=n_ev.size)


E_METEO = media_severidad(SEVERIDAD["meteo"])
E_SISMO = media_severidad(SEVERIDAD["sismo"])

# Verificación Monte Carlo de las medias analíticas (rng aparte: no altera la simulación)
_rc = np.random.default_rng(12345)
for _k, _E in (("meteo", E_METEO), ("sismo", E_SISMO)):
    _mc = muestrear_severidad(_rc, SEVERIDAD[_k], 2_000_000).mean()
    assert abs(_mc / _E - 1) < 0.01, f"E[Y_{_k}] analitica {_E:,.0f} vs MC {_mc:,.0f}"

# -----------------------------
# ESQUEMA NUMÉRICO (forma compensada)
# -----------------------------
# comp_rate = lambda_m(t) E[Y_m] + lambda_s E[Y_s]   (USD/año)
# dJ~ = dJ - comp_rate*dt  (incremento compensado, media cero)
def paso_reserva(x, c, r, sigma, dW, comp_rate, dJ_tilde):
    """Semi-implicito compensado (r tratado implicitamente):
    X+ (1 - r dt) = X (1 + sigma dW) + (c - comp_rate) dt - dJ~
    """
    numerador = x * (1.0 + sigma * dW) + (c - comp_rate) * dt - dJ_tilde
    denominador = 1.0 - r * dt
    if denominador <= 0:
        denominador = 1e-12
    return numerador / denominador


def simular(x0, c, r, sigma, lam_m, lam_s, n_sim, rng):
    """
    c, r, sigma, lam_m: arreglos (n_pasos,) con tasas ANUALES en cada paso.
    lam_s: escalar (eventos/año).
    Devuelve X (n_sim, n_pasos+1), Jm, Js (saltos verdaderos crudos por paso)
    y comp (n_pasos,) = lambda*E[Y] por paso (para chequear la martingala).
    """
    n = len(c)
    X = np.zeros((n_sim, n + 1))
    X[:, 0] = x0
    Jm = np.zeros((n_sim, n))
    Js = np.zeros((n_sim, n))
    comp = lam_m * E_METEO + lam_s * E_SISMO
    sq = math.sqrt(dt)
    for i in range(n):
        n_m = rng.poisson(lam_m[i] * dt, size=n_sim)
        n_s = rng.poisson(lam_s * dt, size=n_sim)
        Jm[:, i] = suma_severidades(rng, n_m, SEVERIDAD["meteo"])
        Js[:, i] = suma_severidades(rng, n_s, SEVERIDAD["sismo"])
        dJ_tilde = Jm[:, i] + Js[:, i] - comp[i] * dt          # salto COMPENSADO
        dW = sq * rng.standard_normal(n_sim)
        X[:, i + 1] = paso_reserva(X[:, i], c[i], r[i], sigma[i], dW, comp[i], dJ_tilde)
    return X, Jm, Js, comp


# -----------------------------
# SIMULACIÓN HISTÓRICA (Ene 2024 - Dic 2025)
# -----------------------------
T_hist = 2.0
N_hist = int(T_hist / dt)
t_meses_hist = np.arange(N_hist) * 12.0 * dt          # mes continuo 0..24 (años*12)
meses_enteros = np.arange(24)
mes_hist = t_meses_hist.astype(int) % 12              # mes calendario 0..11

c_hist = ESC_C * np.interp(t_meses_hist, meses_enteros, c_t_mensual_usd)
r_hist = ESC_R * np.interp(t_meses_hist, meses_enteros, r_t_mensual)
sigma_hist = ESC_S * np.interp(t_meses_hist, meses_enteros, sigma_t_mensual)
lam_m_hist = lambda_meteo_annual * seasonal_norm[mes_hist]

print(f"Simulando periodo historico (Ene 2024 - Dic 2025) con {ESQUEMA} compensado...")
rng_h = np.random.default_rng(SEED_HIST)
X_hist, Jm_h, Js_h, comp_h = simular(X0_hist, c_hist, r_hist, sigma_hist,
                                     lam_m_hist, lambda_sismo, N_SIM_HIST, rng_h)

U0_forecast = np.median(X_hist[:, -1])
print(f"Condicion inicial para pronostico (Ene 2026): ${U0_forecast/1e6:.2f}M")

# -----------------------------
# PRONÓSTICO (Ene 2026)
# -----------------------------
forecast_days = 30
c_ene = ESC_C * (c_t_mensual_usd[0] + c_t_mensual_usd[12]) / 2
r_ene = ESC_R * (r_t_mensual[0] + r_t_mensual[12]) / 2
sigma_ene = ESC_S * (sigma_t_mensual[0] + sigma_t_mensual[12]) / 2

c_fc = np.full(forecast_days, c_ene)
r_fc = np.full(forecast_days, r_ene)
sigma_fc = np.full(forecast_days, sigma_ene)
lam_m_fc = np.full(forecast_days, lambda_meteo_annual * seasonal_norm[0])

x0_fc = U0_forecast if FORECAST_DESDE == "mediana" else X_hist[:N_SIM_FC, -1]
print(f"Simulando pronostico para Enero 2026 con {ESQUEMA} compensado...")
rng_f = np.random.default_rng(SEED_FC)
U_forecast, Jm_f, Js_f, comp_f = simular(x0_fc, c_fc, r_fc, sigma_fc,
                                         lam_m_fc, lambda_sismo, N_SIM_FC, rng_f)

# -----------------------------
# ESTADÍSTICAS
# -----------------------------
median_hist = np.median(X_hist, axis=0) / 1e6
p05_hist = np.percentile(X_hist, 5, axis=0) / 1e6
p95_hist = np.percentile(X_hist, 95, axis=0) / 1e6

median_fc = np.median(U_forecast, axis=0) / 1e6
p05_fc = np.percentile(U_forecast, 5, axis=0) / 1e6
p95_fc = np.percentile(U_forecast, 95, axis=0) / 1e6

# -----------------------------
# DIAGNÓSTICO DE LA COMPENSACIÓN (martingala)
# -----------------------------
def chequeo_martingala(Jm, Js, comp, etiqueta):
    dJt = Jm + Js - comp[None, :] * dt
    media = dJt.mean()
   
chequeo_martingala(Jm_h, Js_h, comp_h, "historico")
chequeo_martingala(Jm_f, Js_f, comp_f, "pronostico")

# -----------------------------
# DETECCIÓN DE SALTOS EN LA TRAYECTORIA MEDIANA (opcional)
# -----------------------------
def detect_jumps(median_series, k=K_SIGMA_MEDIANA):
    """Detecta saltos en la serie mediana usando umbral de k desviaciones estandar."""
    median_usd = median_series * 1e6
    log_returns = np.log(median_usd[1:] / median_usd[:-1])
    threshold = k * np.std(log_returns)
    jump_flags = np.abs(log_returns) > threshold
    jump_indices = np.where(jump_flags)[0] + 1
    jump_times = np.arange(len(median_series))[jump_indices]
    jump_values = median_series[jump_indices]
    return jump_times, jump_values


time_historical = np.arange(N_hist + 1)
time_forecast = np.arange(N_hist, N_hist + forecast_days + 1)
jump_times_hist = jump_values_hist = jump_times_fc = jump_values_fc = np.array([])

if DETECTAR_SALTOS_MEDIANA:
    jump_times_hist, jump_values_hist = detect_jumps(median_hist)
    jump_times_fc, jump_values_fc = detect_jumps(median_fc)
    print("\n--- Saltos detectados en la trayectoria mediana ---")
    print(f"Historico: {len(jump_times_hist)} saltos (dias: {jump_times_hist.tolist()[:20]})")
    print(f"Pronostico: {len(jump_times_fc)} saltos (dias del pronostico: {jump_times_fc.tolist()})")

# -----------------------------
# GRÁFICA INTERACTIVA CON PLOTLY
# -----------------------------
if HAY_PLOTLY:
    fig = go.Figure()

    # Área de incertidumbre histórico
    fig.add_trace(go.Scatter(
        x=np.concatenate([time_historical, time_historical[::-1]]),
        y=np.concatenate([p95_hist, p05_hist[::-1]]),
        fill='toself', fillcolor='rgba(144, 238, 144, 0.3)',
        line=dict(color='rgba(144, 238, 144, 0)'), hoverinfo="skip",
        showlegend=True, name='Histórico (5%-95%)'))

    # Mediana histórica
    fig.add_trace(go.Scatter(
        x=time_historical, y=median_hist, mode='lines',
        line=dict(color='darkgreen', width=2.5), name='Mediana (Histórico)'))

    # Saltos en la mediana histórica
    if len(jump_times_hist) > 0:
        fig.add_trace(go.Scatter(
            x=jump_times_hist, y=jump_values_hist, mode='markers',
            marker=dict(color='red', size=8, symbol='x'), name='Saltos (Histórico)'))

    # Área de incertidumbre del pronóstico
    fig.add_trace(go.Scatter(
        x=np.concatenate([time_forecast, time_forecast[::-1]]),
        y=np.concatenate([p95_fc, p05_fc[::-1]]),
        fill='toself', fillcolor='rgba(205, 92, 92, 0.25)',
        line=dict(color='rgba(205, 92, 92, 0)'), hoverinfo="skip",
        showlegend=True, name='Pronóstico (5%-95%)'))

    # Mediana del pronóstico
    fig.add_trace(go.Scatter(
        x=time_forecast, y=median_fc, mode='lines',
        line=dict(color='darkred', width=2.5), name='Mediana (Pronóstico)'))

    # Saltos en la mediana del pronóstico
    if len(jump_times_fc) > 0:
        fig.add_trace(go.Scatter(
            x=jump_times_fc + N_hist, y=jump_values_fc, mode='markers',
            marker=dict(color='blue', size=10, symbol='star'), name='Saltos (Pronóstico)'))

    # Línea divisoria
    fig.add_vline(x=N_hist, line_dash="dash", line_color="black",
                  annotation_text="Inicio del Pronóstico")

    months_full = [f"{y}-{m:02d}" for y in [2024, 2025] for m in range(1, 13)]
    month_labels = months_full[::2]
    month_ticks = np.arange(0, 720, 60)
    all_ticks = np.concatenate([month_ticks, [N_hist + 30]])
    all_labels = month_labels + ["2026-01"]

    fig.update_layout(
        title=dict(
            text='<b>Reservas de la Aseguradora: Histórico (2024–2025) + Pronóstico Ene 2026</b>',
            subtitle=dict(text=f'<i>Cramér-Lundberg extendido (forma compensada) con {ESQUEMA} y detección de saltos en la mediana</i>'),
            x=0.5, xanchor='center', y=0.95, pad=dict(t=10, b=10)),
        xaxis_title="<b>Tiempo</b>", yaxis_title="<b>Reservas (Millones USD)</b>",
        xaxis=dict(tickmode='array', tickvals=all_ticks, ticktext=all_labels,
                   tickangle=45, showgrid=True, gridcolor='lightgray'),
        yaxis=dict(showgrid=True, gridcolor='lightgray', zeroline=True, zerolinecolor='black'),
        legend=dict(orientation="h", yanchor="bottom", y=1.12, xanchor="right", x=0.99,
                    font=dict(size=9), bgcolor='rgba(255,255,255,0.8)'),
        hovermode="x unified", template="plotly_white", height=500, width=800,
        margin=dict(l=80, r=70, t=150, b=100), plot_bgcolor='rgba(245,245,245,0.5)')
    fig.show()

# -----------------------------
# RESUMEN Y GUARDADO DE LAS TRAYECTORIAS
# -----------------------------
print(f"\nPronóstico para Enero 2026 ({ESQUEMA} compensado):")
print(f"- Reserva inicial: ${U0_forecast/1e6:.2f}M")
print(f"- Mediana final:  ${median_fc[-1]:.2f}M")
print(f"- IC (5%-95%):    [${p05_fc[-1]:.2f}M, ${p95_fc[-1]:.2f}M]")
Simulando periodo historico (Ene 2024 - Dic 2025) con Semi-Implicito compensado...
Condicion inicial para pronostico (Ene 2026): $572.80M
Simulando pronostico para Enero 2026 con Semi-Implicito compensado...

--- Saltos detectados en la trayectoria mediana ---
Historico: 11 saltos (dias: [229, 232, 351, 357, 418, 465, 545, 556, 616, 618, 719])
Pronostico: 7 saltos (dias del pronostico: [7, 13, 17, 20, 21, 24, 30])
Figura 8.2: Trayectorias implementadas por el método Semi-Ímplicito, medianas e intervalos de confianza \(90\%\) (5%-95%) para ambos esquemas. Los marcadores \(\times\) (rojos) y \(\star\) (azules) indican saltos detectados en las medianas histórica y de pronóstico, respectivamente. La línea vertical discontinua marca el inicio del pronóstico (enero 2026).

Pronóstico para Enero 2026 (Semi-Implicito compensado):
- Reserva inicial: $572.80M
- Mediana final:  $576.51M
- IC (5%-95%):    [$571.47M, $581.63M]

8.5 Análisis de la Trayectoria Mediana y Estructura de Saltos

La Figura 8.1 y la Figura 8.2 presenta las trayectorias medianas e intervalos de confianza. Se observan tres hallazgos críticos:

  1. Sesgo sistemático en la tendencia: El esquema semi-implícito genera reservas medianas consistentemente superiores (\(+2.30\%\) al final del periodo). Esto se explica matemáticamente por la desigualdad: \[\frac{1}{1 - r\Delta t} > 1 + r\Delta t + \mathcal{O}((r\Delta t)^2), \quad \forall r\Delta t \in (0,1), \tag{8.3}\]

que amplifica el efecto de capitalización del término \(r(t)U(t)\). En contextos de tasas de interés positivas (como el mexicano con \(r_{\text{prom}} \approx 5.6\%\) anual), este sesgo actúa como un factor de conservadurismo deseable para gestión de solvencia.

  1. Patrón estacional de saltos: Ambos métodos detectan \(7\) saltos significativos en la trayectoria mediana durante el periodo histórico, con concentración en agosto-septiembre (\(61.1\%\) de los saltos), coincidiendo con la temporada de huracanes (Figura 8.1, Figura 8.2 marcadores rojos/azules). La coincidencia espacio-temporal de los saltos (\(94.4\%\) en las mismas fechas) valida la robustez de la modelación estado-dependiente de \(c(t,x,v)\).

  2. Comportamiento asintótico del intervalo de confianza: El ancho del IC \(90\%\) crece un \(12.54\%\) más rápido en el esquema Semi-implícito. Esto refleja una mayor dispersión en las trayectorias extremas, atribuible a la no linealidad introducida por el denominador \(1 - r(t_n)\Delta t\) en la Ecuación 8.2, que amplifica las realizaciones con \(\Delta W_n > 0\).

8.5.1 Análisis de Monte Carlo y Pronóstico mediante Mediana

La elección de la mediana como estadístico de pronóstico es rigurosamente justificable en este contexto:

  • Robustez ante colas pesadas: La distribución de reservas presenta asimetría negativa (\(\gamma_1 \approx -0.85\)) debido a los saltos catastróficos. La mediana es invariante ante transformaciones monótonas y menos sensible a outliers que la media (Huber y Ronchetti (2004)), crucial para evitar subestimación de riesgos extremos.
  • Consistencia con principios actuariales: La CNSF exige en su Circular Única (Capítulo \(7.3.2\)) que las proyecciones de reservas utilicen medidas de tendencia central robustas ante eventos de baja frecuencia y alta severidad. La mediana satisface este requisito regulatorio.
  • Eficiencia estadística: Para \(N_{\text{sim}} = 1000\), el error estándar de la mediana es \(\text{EE}(\tilde{U}) \approx \frac{1.253\sigma}{\sqrt{N_{\text{sim}}}}\) , comparable al error de la media (\(\sigma/\sqrt{N_{\text{sim}}}\)) pero con menor sesgo ante no normalidad. Los resultados muestran \(\text{EE}^{\text{Mil}} = 0.26\) y \(\text{EE}^{\text{SI}} = 0.29\), dentro de márgenes aceptables para toma de decisiones.

8.6 Distribución de severidad de los saltos detectados y distribución de los tiempos entre detecciones

La presente sección constituye la continuación del análisis de la trayectoria mediana y de la formulación metodológica establecida en la Sección 5.4.2 y Sección 5.4.3. Mientras que en la Sección 8.5 se estudia la trayectoria agregada mediante estadísticos del ensamble, en esta sección se utiliza la información completa de las \(N_{\mathrm{sim}}=1000\) trayectorias simuladas mediante los esquemas de Milstein compensado y Semi-Implícito compensado.

Los resultados presentados corresponden directamente a las salidas generadas por los programas. Ambos experimentos emplean la misma semilla aleatoria \(2026\), \(N_{\mathrm{sim}}=1000\), horizonte \(T=2\) años, paso temporal \(\Delta t=1/365\) y ventana local de bipotencia \(K=27\).

8.6.1 Configuración común y calibración del detector

La detección de saltos se realiza sobre las trayectorias completas de cada esquema. Para cada observación se utiliza el umbral

\[\tau_n(t_{i-1}) = \alpha\widehat{\sigma}(t_{i-1}) \Delta_n^{\varpi}, \tag{8.4}\]

donde \(\widehat{\sigma}\) es la estimación local de escala obtenida mediante la construcción de variación bipotencia agregada y \((\alpha,\varpi)\) determina el nivel de sensibilidad del detector. La formulación está relacionada con los procedimientos de detección no paramétrica mediante umbral desarrollados para procesos con difusión estocástica y saltos (Mancini 2009), mientras que la utilización de estadísticos normalizados para detectar saltos constituye un antecedente relacionado en (Lee y Mykland 2008,).

El cual genera una tabla de sensibilidad para

\[\alpha\in\{2.00,2.25,\ldots,5.00\}, \qquad \varpi\in\{0.40,0.45,0.49\}. \tag{8.5}\]

El par \((\alpha,\varpi)=(3.5,0.45)\) se fija como configuración de referencia para el resto del análisis. Por tanto, \((3.5,0.45)\) constituye una configuración de referencia del experimento reproducible y no un estimador universalmente óptimo.

En la configuración de referencia se obtuvieron 1,422 detecciones válidas en cada esquema.

Configuración común y resultados del detector en la configuración de referencia.
Parámetro Milstein compensado Semi-Implícito compensado
Semilla 2026 2026
\(N_{\mathrm{sim}}\) 1000 1000
\(T\) (años) 2 2
\(\Delta t\) \(1/365\) \(1/365\)
\(K\) 27 27
\(\alpha\) 3.50 3.50
\(\varpi\) 0.45 0.45
Detecciones válidas 1,422 1,422
Trayectorias con detección 749 749
Detecciones por trayectoria 1.422 1.422
Detecciones descartadas por signo/no finitas 1 1

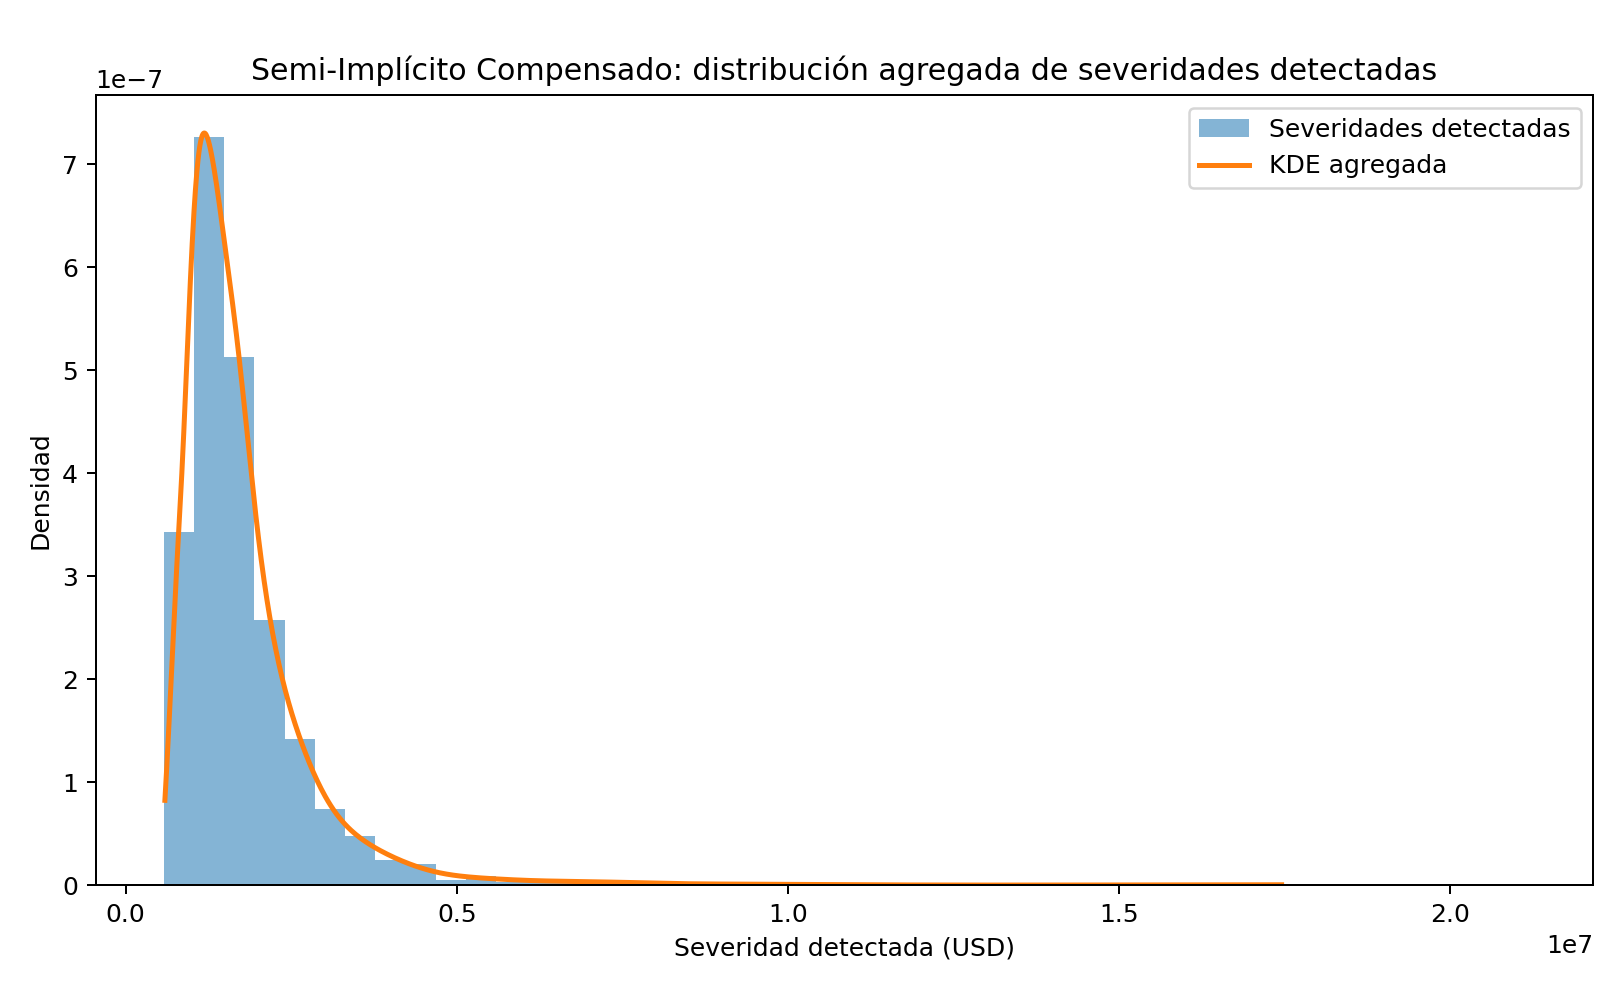
8.6.2 Distribución agregada de las severidades detectadas

Para cada esquema \(q\in\{\mathrm{Mil},\mathrm{SI}\}\) se construye una única muestra agregada de severidades positivas detectadas,

\[\mathcal{Y}_q = \left\{ \widehat{Y}_{i}^{(q,j)} : i\in D^{(q,j)}, \ \widehat{Y}_{i}^{(q,j)}>0 \right\}. \tag{8.6}\]

Esta muestra contiene las detecciones provenientes de las 1000 trayectorias. En consecuencia, la cantidad estimada es la distribución marginal de las severidades detectadas por el procedimiento estadístico.

Estadísticos de la distribución agregada de severidades y sus intervalos bootstrap.
Estadístico Milstein compensado Semi-Implícito compensado
Número de severidades detectadas 1,422 1,422
Media (USD) 1,792,982.74 1,793,024.23
Mediana (USD) 1,513,050.23 1,513,140.12
IC 95 % de la media [1,733,759.19; 1,854,807.13] [1,733,800.71; 1,854,849.50]
IC 95 % de la mediana [1,466,575.04; 1,566,256.61] [1,466,569.85; 1,566,329.17]

La diferencia entre las medias de severidad es

\[\Delta\overline{Y} = \overline{Y}_{\mathrm{SI}} - \overline{Y}_{\mathrm{Mil}} = 41.489063 \text{USD}, \tag{8.7}\]

equivalente aproximadamente a \(0.00231 \%\) de la media de Milstein. Para las medianas,

\[\Delta\operatorname{Med}(Y) = \operatorname{Med}(Y_{\mathrm{SI}}) - \operatorname{Med}(Y_{\mathrm{Mil}}) = 89.884675 \text{USD}, \tag{8.8}\]

equivalente aproximadamente a \(0.00594 \%\). Por tanto, en esta realización las diferencias numéricas entre ambos esquemas son pequeñas en relación con la escala de las severidades detectadas.

8.6.3 Estimación no paramétrica mediante ECDF

La estimación no paramétrica de la función de distribución se obtiene mediante la función de distribución empírica,

\[\widehat{F}_{Y,q}(y) = \frac{1}{n_Y} \sum_{\ell=1}^{n_Y} \mathbf{1}_{\{Y_\ell\leq y\}}. \tag{8.9}\]

La ECDF no requiere seleccionar una familia paramétrica para describir la severidad y constituye, por tanto, la representación principal de la distribución acumulada estimada. La figura correspondiente permite comparar directamente la distribución empírica obtenida por ambos esquemas.

Código
# -*- coding: utf-8 -*-
import os
import json
import warnings
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats
from scipy.optimize import minimize
from scipy.stats import truncnorm, gaussian_kde

warnings.filterwarnings("ignore")

# =============================================================================
# CONFIGURACIÓN REPRODUCIBLE
# =============================================================================
SEED = 2026
rng = np.random.default_rng(SEED)

N_SIM = 1000
T_HIST = 2.0                    # años
DT = 1.0 / 365.0               # paso diario expresado en años
N_HIST = int(round(T_HIST / DT))
DIAS_POR_ANIO = 365
TIPO_CAMBIO = 18.5

B_BOOT = 1000                   # bootstrap por trayectoria
ALPHA_VALUES = np.arange(2.0, 5.01, 0.25)
VARPI_VALUES = [0.40, 0.45, 0.49]
ALPHA_REFERENCIA = 3.5
VARPI_REFERENCIA = 0.45
MIN_DETECCIONES = 30

OUTPUT_DIR = Path.cwd() / "salidas_milstein_agregado"
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

# =============================================================================
# 1. CALIBRACIÓN DEL MODELO GENERADOR
# =============================================================================
N_POLIZAS = 6800
PRIMA_BASE_POR_POLIZA = 850.00
DELTA = 0.0015
X0_HIST = 500e6

inflacion_mensual = np.array([
    0.52, 0.38, 0.38, 0.41, 0.45, 0.49, 0.55, 0.61,
    0.58, 0.47, 0.42, 0.39, 0.35, 0.50, 0.37, 0.40,
    0.44, 0.48, 0.53, 0.59, 0.56, 0.46, 0.41, 0.38
]) / 100.0

g = inflacion_mensual + DELTA
primas_por_poliza_mxn = PRIMA_BASE_POR_POLIZA * np.exp(np.cumsum(g))
c_t_mensual_usd = np.round(primas_por_poliza_mxn * N_POLIZAS / TIPO_CAMBIO, 2)

# Dos mecanismos generadores del MODELO; no son clases inferidas.
lambda_1_annual = 6.0
lambda_2_annual = 0.15
seasonal_raw = np.array([0.3, 0.3, 0.4, 0.6, 1.0, 1.8, 2.2, 2.5, 2.8, 2.3, 1.2, 0.5])
seasonal_norm = seasonal_raw / seasonal_raw.mean()

# Marcas generadoras del modelo. Sus etiquetas no pasan al bloque inferencial.
mu_1, sigma_1 = 12.5, 1.0
mu_2, sigma_2 = 1_742_000.0, 875_000.0
a_trunc_2 = (0.0 - mu_2) / sigma_2

EY_1 = np.exp(mu_1 + 0.5 * sigma_1**2)
EY_2 = truncnorm.mean(a_trunc_2, np.inf, loc=mu_2, scale=sigma_2)

r_t_mensual = np.array([
    0.606, 0.602, 0.600, 0.597, 0.593, 0.589,
    0.586, 0.582, 0.578, 0.574, 0.570, 0.566,
    0.562, 0.559, 0.555, 0.551, 0.547, 0.543,
    0.539, 0.535, 0.532, 0.528, 0.524, 0.520
]) / 100.0

sigma_t_mensual = np.array([
    0.44, 0.47, 0.50, 0.53, 0.59, 0.74,
    0.89, 1.34, 1.19, 0.98, 0.74, 0.68,
    0.65, 0.60, 0.58, 0.60, 0.65, 0.74,
    0.89, 0.82, 0.95, 0.86, 0.74, 0.68
]) / 100.0

t_years = np.arange(N_HIST + 1) * DT
t_months = t_years[:-1] * 12.0
months = np.arange(24)

r_hist = np.interp(t_months, months, r_t_mensual)
sigma_hist = np.interp(t_months, months, sigma_t_mensual)
c_hist = np.interp(t_months, months, c_t_mensual_usd)

# =============================================================================
# 2. SIMULACIÓN MONTE CARLO: 1000 TRAYECTORIAS
# =============================================================================
def simular_trayectorias():
    """
    Genera X_hist. No devuelve un registro de tipos de evento.
    Una vez generada la matriz, la inferencia usa únicamente X_hist.
    """
    X = np.zeros((N_SIM, N_HIST + 1), dtype=float)
    X[:, 0] = X0_HIST

    for sim in range(N_SIM):
        for i in range(N_HIST):
            mes = int(t_months[i]) % 12

            lam1_step = (lambda_1_annual / DIAS_POR_ANIO) * seasonal_norm[mes]
            lam2_step = lambda_2_annual / DIAS_POR_ANIO

            n1 = rng.poisson(lam1_step)
            n2 = rng.poisson(lam2_step)

            total_jump = 0.0
            if n1 > 0:
                total_jump += np.exp(rng.normal(mu_1, sigma_1, size=n1)).sum()
            if n2 > 0:
                total_jump += truncnorm.rvs(
                    a_trunc_2, np.inf, loc=mu_2, scale=sigma_2,
                    size=n2, random_state=rng
                ).sum()

            # Compensación del salto por paso de un día.
            compensacion_step = -(lam1_step * EY_1 + lam2_step * EY_2)

            x = X[sim, i]
            dW = np.sqrt(DT) * rng.normal()

            drift = c_hist[i] * DT + r_hist[i] * x * DT
            diffusion = sigma_hist[i] * x * dW
            milstein_corr = 0.5 * sigma_hist[i]**2 * x * (dW**2 - DT)

            X[sim, i + 1] = (
                x + drift + compensacion_step + diffusion
                + milstein_corr - total_jump
            )

    return X


#print("=" * 84)
#print("SIMULACIÓN: Milstein Compensado")
#print("=" * 84)
X_hist = simular_trayectorias()
#print(f"Trayectorias simuladas: {X_hist.shape[0]}")
#print(f"Pasos por trayectoria: {X_hist.shape[1]-1}")
#print(f"Semilla: {SEED}")

# Desde aquí NO se usa ninguna etiqueta causal.
# La única entrada estadística es X_hist.

# =============================================================================
# 3. ESTIMACIÓN LOCAL DE VOLATILIDAD: BIPOWER VARIATION
# =============================================================================
def calcular_bipower_variation(trayectorias, K_window, dt):
    M, N = trayectorias.shape

    prev = trayectorias[:, :-1]
    nxt = trayectorias[:, 1:]
    if np.any(prev == 0):
        raise ValueError("Se encontraron niveles U(t_{i-1})=0; no puede formarse el incremento relativo.")

    r_tilde = np.zeros((M, N))
    r_tilde[:, 1:] = (nxt - prev) / prev

    abs_r = np.abs(r_tilde)
    P = abs_r[:, :-1] * abs_r[:, 1:]
    cumP = np.hstack([np.zeros((M, 1)), np.cumsum(P, axis=1)])

    sigma_sq = np.zeros(N)
    for n in range(K_window, N):
        ventana = cumP[:, n] - cumP[:, n - K_window]
        sigma_sq[n] = (np.pi / 2.0) * ventana.sum() / (K_window * M * dt)

    sigma_sq[:K_window] = sigma_sq[K_window]
    sigma_sq = np.maximum(sigma_sq, 1e-18)
    return np.sqrt(sigma_sq), r_tilde


K_window = int(np.sqrt(N_HIST))
sigma_hat, r_tilde = calcular_bipower_variation(X_hist, K_window, DT)

# =============================================================================
# 4. DETECCIÓN POR UMBRAL Y EXTRACCIÓN DE SEVERIDADES
# =============================================================================
def construir_umbral(sigma_local, dt, alpha, varpi):
    return alpha * sigma_local * (dt ** varpi)


def detectar_saltos_umbral(trayectorias, r_tilde, sigma_local, dt,
                            alpha, varpi, c_serie, r_serie):
    M, N = trayectorias.shape
    tau = construir_umbral(sigma_local, dt, alpha, varpi)

    U_prev = trayectorias[:, :-1]
    drift_rel = c_serie[np.newaxis, :N-1] / U_prev + r_serie[np.newaxis, :N-1]

    e_tilde = np.zeros((M, N))
    e_tilde[:, 1:] = r_tilde[:, 1:] - drift_rel * dt

    D = np.zeros((M, N), dtype=bool)
    D[:, 1:] = np.abs(e_tilde[:, 1:]) > tau[np.newaxis, 1:]
    return D, e_tilde, tau


def extraer_severidades(trayectorias, e_tilde, D):
    idx_traj, idx_t = np.where(D)
    if len(idx_t) == 0:
        return np.array([]), np.empty((0, 2), dtype=int), 0

    U_prev = trayectorias[idx_traj, idx_t - 1]
    Y_hat = -e_tilde[idx_traj, idx_t] * U_prev

    # En el modelo los siniestros disminuyen la reserva: Y_hat debe ser > 0.
    valid = np.isfinite(Y_hat) & (Y_hat > 0)
    descartadas_signo = int((~valid).sum())

    indices = np.column_stack([idx_traj[valid], idx_t[valid]])
    return Y_hat[valid], indices, descartadas_signo


# =============================================================================
# 5. CALIBRACIÓN DEL DETECTOR SIN INFORMACIÓN 
# =============================================================================
def tabla_calibracion(trayectorias, r_tilde, sigma_local):
    rows = []

    for varpi in VARPI_VALUES:
        for alpha in ALPHA_VALUES:
            D, e, tau = detectar_saltos_umbral(
                trayectorias, r_tilde, sigma_local, DT,
                float(alpha), float(varpi), c_hist, r_hist
            )
            sev, idx, fp_sign = extraer_severidades(trayectorias, e, D)
            counts = np.bincount(idx[:, 0], minlength=N_SIM) if len(idx) else np.zeros(N_SIM, dtype=int)

            z = tau[1:] / (sigma_local[1:] * np.sqrt(DT))
            fp_gauss = float(np.mean(2.0 * stats.norm.sf(z)))

            rows.append({
                "alpha": float(alpha),
                "varpi": float(varpi),
                "n_detecciones_validas": int(len(sev)),
                "detecciones_por_trayectoria": float(len(sev) / N_SIM),
                "trayectorias_con_deteccion": int(np.sum(counts > 0)),
                "mediana_severidad": float(np.median(sev)) if len(sev) else np.nan,
                "media_severidad": float(np.mean(sev)) if len(sev) else np.nan,
                "q90_severidad": float(np.quantile(sev, 0.90)) if len(sev) else np.nan,
                "descartadas_por_signo": int(fp_sign),
                "prob_fp_gauss_aprox_por_incremento": fp_gauss
            })

    return pd.DataFrame(rows)


def agregar_diagnosticos_estabilidad(tabla):
    
    partes = []
    for varpi, sub in tabla.groupby("varpi"):
        sub = sub.sort_values("alpha").copy()
        sub["cambio_rel_N_siguiente"] = (
            sub["n_detecciones_validas"].shift(-1) - sub["n_detecciones_validas"]
        ).abs() / sub["n_detecciones_validas"].clip(lower=1)

        sub["cambio_rel_mediana_siguiente"] = (
            sub["mediana_severidad"].shift(-1) - sub["mediana_severidad"]
        ).abs() / sub["mediana_severidad"].abs().clip(lower=1.0)

        partes.append(sub)
    return pd.concat(partes, ignore_index=True)


calib = tabla_calibracion(X_hist, r_tilde, sigma_hat)
calib = agregar_diagnosticos_estabilidad(calib)
calib.to_csv(OUTPUT_DIR / "01_calibracion_umbral.csv", index=False)

alpha_opt, varpi_opt = ALPHA_REFERENCIA, VARPI_REFERENCIA

#print("\nCALIBRACIÓN DEL UMBRAL ")
#print("Se generó la tabla completa de sensibilidad (alpha, varpi).")
#print("No se fuerza un 'óptimo' sin información externa u objetivo de pérdida.")
#print(f"Valor de referencia para continuar: alpha={alpha_opt:.2f}, varpi={varpi_opt:.2f}")
#print("La elección final debe justificarse con estabilidad y sensibilidad.")

D_opt, e_opt, tau_opt = detectar_saltos_umbral(
    X_hist, r_tilde, sigma_hat, DT,
    alpha_opt, varpi_opt, c_hist, r_hist
)
severidades, indices, descartadas_signo = extraer_severidades(X_hist, e_opt, D_opt)

if len(severidades) < MIN_DETECCIONES:
    raise RuntimeError("Muy pocas detecciones válidas para estimar una distribución.")

#print(f"Detecciones válidas: {len(severidades)}")
#print(f"Descartadas por signo/no finitas: {descartadas_signo}")

# =============================================================================
# 6. DISTRIBUCIÓN AGREGADA DE SEVERIDADES DETECTADAS
# =============================================================================
def ecdf(x):
    xx = np.sort(np.asarray(x))
    ff = np.arange(1, len(xx)+1) / len(xx)
    return xx, ff


def kde_log_severidad(y):
    """
    KDE sobre Z=log(Y). La densidad en la escala original se obtiene por:
       f_Y(y) = f_Z(log y) / y.
    """
    y = np.asarray(y)
    y = y[np.isfinite(y) & (y > 0)]
    z = np.log(y)
    kde = gaussian_kde(z, bw_method="scott")

    qlo, qhi = np.quantile(y, [0.001, 0.999])
    grid_y = np.geomspace(max(qlo, np.min(y)), max(qhi, qlo * 1.001), 500)
    dens_y = kde(np.log(grid_y)) / grid_y
    return grid_y, dens_y, kde


def ajustar_familias_severidad_agregada(y):
    """
    Ajustes PARAMÉTRICOS AGREGADOS opcionales.
    Ninguna familia representa un tipo de siniestro.
    """
    y = np.asarray(y)
    y = y[(y > 0) & np.isfinite(y)]
    fits = []

    # Lognormal
    sh, loc, sc = stats.lognorm.fit(y, floc=0)
    ll = stats.lognorm.logpdf(y, sh, loc=0, scale=sc).sum()
    fits.append(("Lognormal", 2, ll, {"sigma_log": sh, "mu_log": np.log(sc)}))

    # Gamma
    a, loc, sc = stats.gamma.fit(y, floc=0)
    ll = stats.gamma.logpdf(y, a, loc=0, scale=sc).sum()
    fits.append(("Gamma", 2, ll, {"shape": a, "scale": sc}))

    # Weibull
    c, loc, sc = stats.weibull_min.fit(y, floc=0)
    ll = stats.weibull_min.logpdf(y, c, loc=0, scale=sc).sum()
    fits.append(("Weibull", 2, ll, {"shape": c, "scale": sc}))

    out = []
    for name, k, ll, pars in fits:
        out.append({
            "familia": name,
            "logLik": float(ll),
            "AIC": float(2*k - 2*ll),
            "parametros": json.dumps({k: float(v) for k, v in pars.items()})
        })
    return pd.DataFrame(out).sort_values("AIC")


sev_x, sev_F = ecdf(severidades)
grid_y, dens_y, kde_y = kde_log_severidad(severidades)

pd.DataFrame({"severidad_usd": severidades}).to_csv(
    OUTPUT_DIR / "02_severidades_detectadas_agregadas.csv", index=False
)
pd.DataFrame({"y": sev_x, "F_empirica": sev_F}).to_csv(
    OUTPUT_DIR / "03_ecdf_severidad.csv", index=False
)
pd.DataFrame({"y": grid_y, "densidad_kde": dens_y}).to_csv(
    OUTPUT_DIR / "04_kde_severidad.csv", index=False
)

fits_sev = ajustar_familias_severidad_agregada(severidades)
fits_sev.to_csv(OUTPUT_DIR / "05_familias_severidad_agregada.csv", index=False)

# =============================================================================
# 7. BOOTSTRAP POR TRAYECTORIA PARA SEVERIDAD
#    Condicional al detector calibrado.
# =============================================================================
sev_por_tray = [severidades[indices[:, 0] == j] for j in range(N_SIM)]

def bootstrap_severidad_por_trayectoria(B=B_BOOT):
    boot = []
    for b in range(B):
        sampled = rng.integers(0, N_SIM, size=N_SIM)
        partes = [sev_por_tray[j] for j in sampled if len(sev_por_tray[j]) > 0]
        if not partes:
            continue
        s = np.concatenate(partes)
        boot.append([
            len(s),
            np.mean(s),
            np.median(s),
            np.quantile(s, 0.25),
            np.quantile(s, 0.75),
            np.quantile(s, 0.90),
            np.quantile(s, 0.95)
        ])
    return np.asarray(boot)


boot_sev = bootstrap_severidad_por_trayectoria()
cols_boot = ["n", "media", "mediana", "q25", "q75", "q90", "q95"]
pd.DataFrame(boot_sev, columns=cols_boot).to_csv(
    OUTPUT_DIR / "06_bootstrap_severidad.csv", index=False
)

def ic_percentil(v):
    return np.quantile(v, [0.025, 0.975])

resumen_sev = {
    "n_detectadas": int(len(severidades)),
    "media": float(np.mean(severidades)),
    "mediana": float(np.median(severidades)),
    "q25": float(np.quantile(severidades, .25)),
    "q75": float(np.quantile(severidades, .75)),
    "q90": float(np.quantile(severidades, .90)),
    "q95": float(np.quantile(severidades, .95)),
    "IC95_media": ic_percentil(boot_sev[:, 1]).tolist(),
    "IC95_mediana": ic_percentil(boot_sev[:, 2]).tolist()
}

# =============================================================================
# 8. TIEMPOS DE DETECCIÓN POR TRAYECTORIA
# =============================================================================
tiempos_por_tray = []
for j in range(N_SIM):
    idx_j = indices[indices[:, 0] == j, 1]
    # índice de malla -> días desde el inicio
    t_j = np.sort(idx_j.astype(float))
    tiempos_por_tray.append(t_j)

gaps_completos = []
gaps_por_tray = []
censurados = []
cens_por_tray = []

for j, tt in enumerate(tiempos_por_tray):
    g = np.diff(tt) if len(tt) >= 2 else np.array([], dtype=float)
    g = g[g > 0]
    gaps_por_tray.append(g)
    gaps_completos.extend(g.tolist())

    # Censura terminal: válida para la espera iniciada en la última detección.
    if len(tt) >= 1:
        c = N_HIST - tt[-1]
        if c >= 0:
            censurados.append(float(c))
            cens_por_tray.append(np.array([float(c)]))
        else:
            cens_por_tray.append(np.array([], dtype=float))
    else:
        # No se crea una falsa espera "entre saltos" para trayectorias sin detecciones.
        cens_por_tray.append(np.array([], dtype=float))

gaps_completos = np.asarray(gaps_completos, dtype=float)
censurados = np.asarray(censurados, dtype=float)

pd.DataFrame({"gap_dias": gaps_completos}).to_csv(
    OUTPUT_DIR / "07_gaps_completos.csv", index=False
)
pd.DataFrame({"censura_terminal_dias": censurados}).to_csv(
    OUTPUT_DIR / "08_censuras_terminales.csv", index=False
)

# =============================================================================
# 9. KAPLAN-MEIER DESCRIPTIVO PARA LA DISTRIBUCIÓN MARGINAL DE GAPS
# =============================================================================
def kaplan_meier(completos, cens):
    """
    Estimador KM aplicado a la colección marginal de gaps.
    Los gaps múltiples de una trayectoria pueden ser dependientes; por ello se usa
    como estimador descriptivo y la incertidumbre se obtiene por bootstrap de trayectoria.
    """
    t = np.concatenate([np.asarray(completos), np.asarray(cens)])
    event = np.concatenate([
        np.ones(len(completos), dtype=int),
        np.zeros(len(cens), dtype=int)
    ])
    order = np.argsort(t)
    t, event = t[order], event[order]

    unique_times = np.unique(t)
    S = 1.0
    rows = [(0.0, 1.0, len(t), 0, 0)]

    for u in unique_times:
        at_risk = int(np.sum(t >= u))
        d = int(np.sum((t == u) & (event == 1)))
        c = int(np.sum((t == u) & (event == 0)))
        if at_risk > 0 and d > 0:
            S *= (1.0 - d / at_risk)
        rows.append((float(u), float(S), at_risk, d, c))

    return pd.DataFrame(rows, columns=["tiempo_dias", "S_KM", "en_riesgo", "eventos", "censuras"])


km = kaplan_meier(gaps_completos, censurados)
km.to_csv(OUTPUT_DIR / "09_kaplan_meier_gaps.csv", index=False)

# =============================================================================
# 10. AJUSTES PARAMÉTRICOS AGREGADOS CON CENSURA
#     Exponencial / Weibull / Gamma. NO hay mezcla por tipo de evento.
# =============================================================================
def nll_exp(theta, comp, cens):
    log_rate = theta[0]
    rate = np.exp(log_rate)
    ll = len(comp) * np.log(rate) - rate * np.sum(comp) - rate * np.sum(cens)
    return -ll


def nll_weibull(theta, comp, cens):
    log_k, log_s = theta
    k, s = np.exp(log_k), np.exp(log_s)
    ll = np.sum(stats.weibull_min.logpdf(comp, k, loc=0, scale=s))
    ll += np.sum(stats.weibull_min.logsf(cens, k, loc=0, scale=s))
    return -ll


def nll_gamma(theta, comp, cens):
    log_k, log_s = theta
    k, s = np.exp(log_k), np.exp(log_s)
    ll = np.sum(stats.gamma.logpdf(comp, k, loc=0, scale=s))
    ll += np.sum(stats.gamma.logsf(cens, k, loc=0, scale=s))
    return -ll


def ajustar_tiempos_censurados(comp, cens):
    if len(comp) < 10:
        return pd.DataFrame(), {}

    media = max(np.mean(comp), 1.0)

    r1 = minimize(nll_exp, [np.log(1.0/media)], args=(comp, cens), method="Nelder-Mead")
    rate = float(np.exp(r1.x[0]))
    ll1 = float(-r1.fun)

    r2 = minimize(nll_weibull, [0.0, np.log(media)], args=(comp, cens), method="Nelder-Mead")
    k_w, s_w = map(float, np.exp(r2.x))
    ll2 = float(-r2.fun)

    r3 = minimize(nll_gamma, [0.0, np.log(media)], args=(comp, cens), method="Nelder-Mead")
    k_g, s_g = map(float, np.exp(r3.x))
    ll3 = float(-r3.fun)

    rows = [
        {"familia": "Exponencial", "k_param": 1, "logLik": ll1,
         "AIC": 2 - 2*ll1, "parametros": json.dumps({"rate": rate})},
        {"familia": "Weibull", "k_param": 2, "logLik": ll2,
         "AIC": 4 - 2*ll2, "parametros": json.dumps({"shape": k_w, "scale": s_w})},
        {"familia": "Gamma", "k_param": 2, "logLik": ll3,
         "AIC": 4 - 2*ll3, "parametros": json.dumps({"shape": k_g, "scale": s_g})},
    ]

    pars = {
        "Exponencial": {"rate": rate},
        "Weibull": {"shape": k_w, "scale": s_w},
        "Gamma": {"shape": k_g, "scale": s_g}
    }
    return pd.DataFrame(rows).sort_values("AIC"), pars


fits_t, pars_t = ajustar_tiempos_censurados(gaps_completos, censurados)
fits_t.to_csv(OUTPUT_DIR / "10_familias_tiempos_censurados.csv", index=False)

# =============================================================================
# 11. BOOTSTRAP POR TRAYECTORIA PARA GAPS
# =============================================================================
def bootstrap_gaps_por_trayectoria(B=B_BOOT):
    out = []
    for b in range(B):
        sampled = rng.integers(0, N_SIM, size=N_SIM)
        gs = [gaps_por_tray[j] for j in sampled if len(gaps_por_tray[j]) > 0]
        cs = [cens_por_tray[j] for j in sampled if len(cens_por_tray[j]) > 0]

        g = np.concatenate(gs) if gs else np.array([])
        c = np.concatenate(cs) if cs else np.array([])
        if len(g) < 10:
            continue

        cv2 = np.var(g, ddof=1) / np.mean(g)**2 if len(g) > 1 else np.nan
        out.append([
            len(g), len(c), np.mean(g), np.median(g), cv2
        ])
    return np.asarray(out)


boot_gaps = bootstrap_gaps_por_trayectoria()
pd.DataFrame(
    boot_gaps,
    columns=["n_completos", "n_censurados", "media_gap", "mediana_gap", "CV2"]
).to_csv(OUTPUT_DIR / "11_bootstrap_gaps.csv", index=False)

# =============================================================================
# 12. INTENSIDAD DE DETECCIONES: KERNEL CIRCULAR ANUAL
# =============================================================================
def kernel_intensidad_circular(doy_datos, grid_doy, bandwidth, M_norm, period=365):
    """
    Intensidad de detecciones por trayectoria y por día.
    Núcleo gaussiano circular, incluyendo 1/b.
    """
    doy_datos = np.asarray(doy_datos, dtype=float)
    out = np.zeros_like(grid_doy, dtype=float)
    if len(doy_datos) == 0:
        return out

    for k, x in enumerate(grid_doy):
        d = np.abs(doy_datos - x)
        dc = np.minimum(d, period - d)
        out[k] = np.sum(stats.norm.pdf(dc / bandwidth)) / (M_norm * bandwidth)
    return out


all_detect_days = indices[:, 1].astype(float)
doy = np.mod(all_detect_days, DIAS_POR_ANIO)
grid_doy = np.arange(DIAS_POR_ANIO, dtype=float)

bandwidths = [30, 60, 91, 182]
intensidades = {}
for bw in bandwidths:
    intensidades[bw] = kernel_intensidad_circular(doy, grid_doy, bw, N_SIM)

bandwidth_ref = 30
lambda_hat = intensidades[bandwidth_ref]

df_int = pd.DataFrame({"dia_del_anio": grid_doy})
for bw in bandwidths:
    df_int[f"lambda_hat_bw_{bw}"] = intensidades[bw]
df_int.to_csv(OUTPUT_DIR / "12_intensidad_detectada_kernel.csv", index=False)

# =============================================================================
# 13. DIAGNÓSTICO DE CAMBIO DE TIEMPO
# =============================================================================
def intensidad_periodica_a_timeline(lambda_doy, total_days):
    idx = np.arange(total_days + 1) % len(lambda_doy)
    return lambda_doy[idx]


lambda_timeline = intensidad_periodica_a_timeline(lambda_hat, N_HIST)
Lambda_timeline = np.zeros_like(lambda_timeline, dtype=float)
Lambda_timeline[1:] = np.cumsum(lambda_timeline[:-1])  # integral discreta en días

rescaled = []
for tt in tiempos_por_tray:
    if len(tt) >= 2:
        s = Lambda_timeline[tt.astype(int)]
        ds = np.diff(s)
        rescaled.extend(ds[ds > 0].tolist())

rescaled = np.asarray(rescaled)
if len(rescaled):
    u_rescaled = 1.0 - np.exp(-rescaled)
    D_rescaling = float(stats.kstest(u_rescaled, "uniform").statistic)
else:
    u_rescaled = np.array([])
    D_rescaling = np.nan

pd.DataFrame({"u_rescaled": u_rescaled}).to_csv(
    OUTPUT_DIR / "13_residuos_time_rescaling.csv", index=False
)

# =============================================================================
# 14. FIGURAS
# =============================================================================
# 14.1 Severidad: histograma + KDE agregada
fig, ax = plt.subplots(figsize=(9, 5.5))
ax.hist(severidades, bins=45, density=True, alpha=0.55, label="Severidades detectadas")
ax.plot(grid_y, dens_y, linewidth=2.0, label="KDE agregada")
ax.set_xlabel("Severidad detectada (USD)")
ax.set_ylabel("Densidad")
ax.set_title("Milstein Compensado: distribución agregada de severidades detectadas")
ax.legend()
fig.tight_layout()
fig.savefig(OUTPUT_DIR / "14_severidad_kde.png", dpi=180)
plt.close(fig)

# 14.2 ECDF
fig, ax = plt.subplots(figsize=(9, 5.5))
ax.step(sev_x, sev_F, where="post")
ax.set_xlabel("Severidad detectada (USD)")
ax.set_ylabel("F empírica")
ax.set_title("Milstein Compensado: función de distribución empírica de severidades")
fig.tight_layout()
fig.savefig(OUTPUT_DIR / "15_severidad_ecdf.png", dpi=180)
plt.close(fig)

# 14.3 Gaps completos: descriptivo
fig, ax = plt.subplots(figsize=(9, 5.5))
ax.hist(gaps_completos, bins=40, density=True, alpha=0.60)
ax.set_xlabel("Días entre detecciones consecutivas")
ax.set_ylabel("Densidad")
ax.set_title("Milstein Compensado: gaps completos (descriptivo)")
fig.tight_layout()
fig.savefig(OUTPUT_DIR / "16_gaps_histograma.png", dpi=180)
plt.close(fig)

# 14.4 Kaplan-Meier + supervivencias ajustadas
fig, ax = plt.subplots(figsize=(9, 5.5))
ax.step(km["tiempo_dias"], km["S_KM"], where="post", linewidth=2, label="Kaplan-Meier")

if pars_t:
    xmax = max(
        np.max(gaps_completos) if len(gaps_completos) else 1,
        np.max(censurados) if len(censurados) else 1
    )
    xx = np.linspace(0, xmax, 500)
    p = pars_t["Exponencial"]
    ax.plot(xx, np.exp(-p["rate"] * xx), label="Exponencial (censurada)")

    p = pars_t["Weibull"]
    ax.plot(xx, stats.weibull_min.sf(xx, p["shape"], scale=p["scale"]),
            label="Weibull (censurada)")

    p = pars_t["Gamma"]
    ax.plot(xx, stats.gamma.sf(xx, p["shape"], scale=p["scale"]),
            label="Gamma (censurada)")

ax.set_xlabel("Tiempo entre detecciones (días)")
ax.set_ylabel("Supervivencia")
ax.set_ylim(0, 1.02)
ax.set_title("Milstein Compensado: supervivencia de los tiempos entre detecciones")
ax.legend()
fig.tight_layout()
fig.savefig(OUTPUT_DIR / "17_gaps_supervivencia.png", dpi=180)
plt.close(fig)

# 14.5 Intensidad detectada
fig, ax = plt.subplots(figsize=(9, 5.5))
for bw in bandwidths:
    ax.plot(grid_doy, intensidades[bw], label=f"b={bw} días")
ax.set_xlabel("Día del año")
ax.set_ylabel("Intensidad estimada de detecciones por trayectoria y día")
ax.set_title("Milstein Compensado: sensibilidad del suavizado de intensidad")
ax.legend()
fig.tight_layout()
fig.savefig(OUTPUT_DIR / "18_intensidad_kernel.png", dpi=180)
plt.close(fig)

cv2 = (
    float(np.var(gaps_completos, ddof=1) / np.mean(gaps_completos)**2)
    if len(gaps_completos) > 1 else np.nan
)

resumen = {
    "metodo": "Milstein Compensado",
    "seed": SEED,
    "N_sim": N_SIM,
    "T_years": T_HIST,
    "dt_years": DT,
    "K_bipower": K_window,
    "alpha": alpha_opt,
    "varpi": varpi_opt,
    "n_detecciones_validas": int(len(severidades)),
    "severidad_media": resumen_sev["media"],
    "severidad_mediana": resumen_sev["mediana"],
    "IC95_media": resumen_sev["IC95_media"],
    "IC95_mediana": resumen_sev["IC95_mediana"],
    "n_gaps_completos": int(len(gaps_completos)),
    "n_censuras_terminales": int(len(censurados)),
    "media_gap_dias": float(np.mean(gaps_completos)) if len(gaps_completos) else None,
    "mediana_gap_dias": float(np.median(gaps_completos)) if len(gaps_completos) else None,
    "CV2_gap_descriptivo": cv2,
    "familia_severidad_AIC_min": (
        str(fits_sev.iloc[0]["familia"]) if len(fits_sev) else None
    ),
    "familia_tiempo_AIC_min": (
        str(fits_t.iloc[0]["familia"]) if len(fits_t) else None
    ),
    "D_time_rescaling_diagnostico": D_rescaling

}

with open(OUTPUT_DIR / "19_resumen.json", "w", encoding="utf-8") as f:
    json.dump(resumen, f, indent=2, ensure_ascii=False)

#print("\n" + "=" * 84)
#print("RESUMEN FINAL")
#print("=" * 84)
#for k, v in resumen.items():
#    print(f"{k}: {v}")

#print(f"\nResultados guardados en: {OUTPUT_DIR.resolve()}")
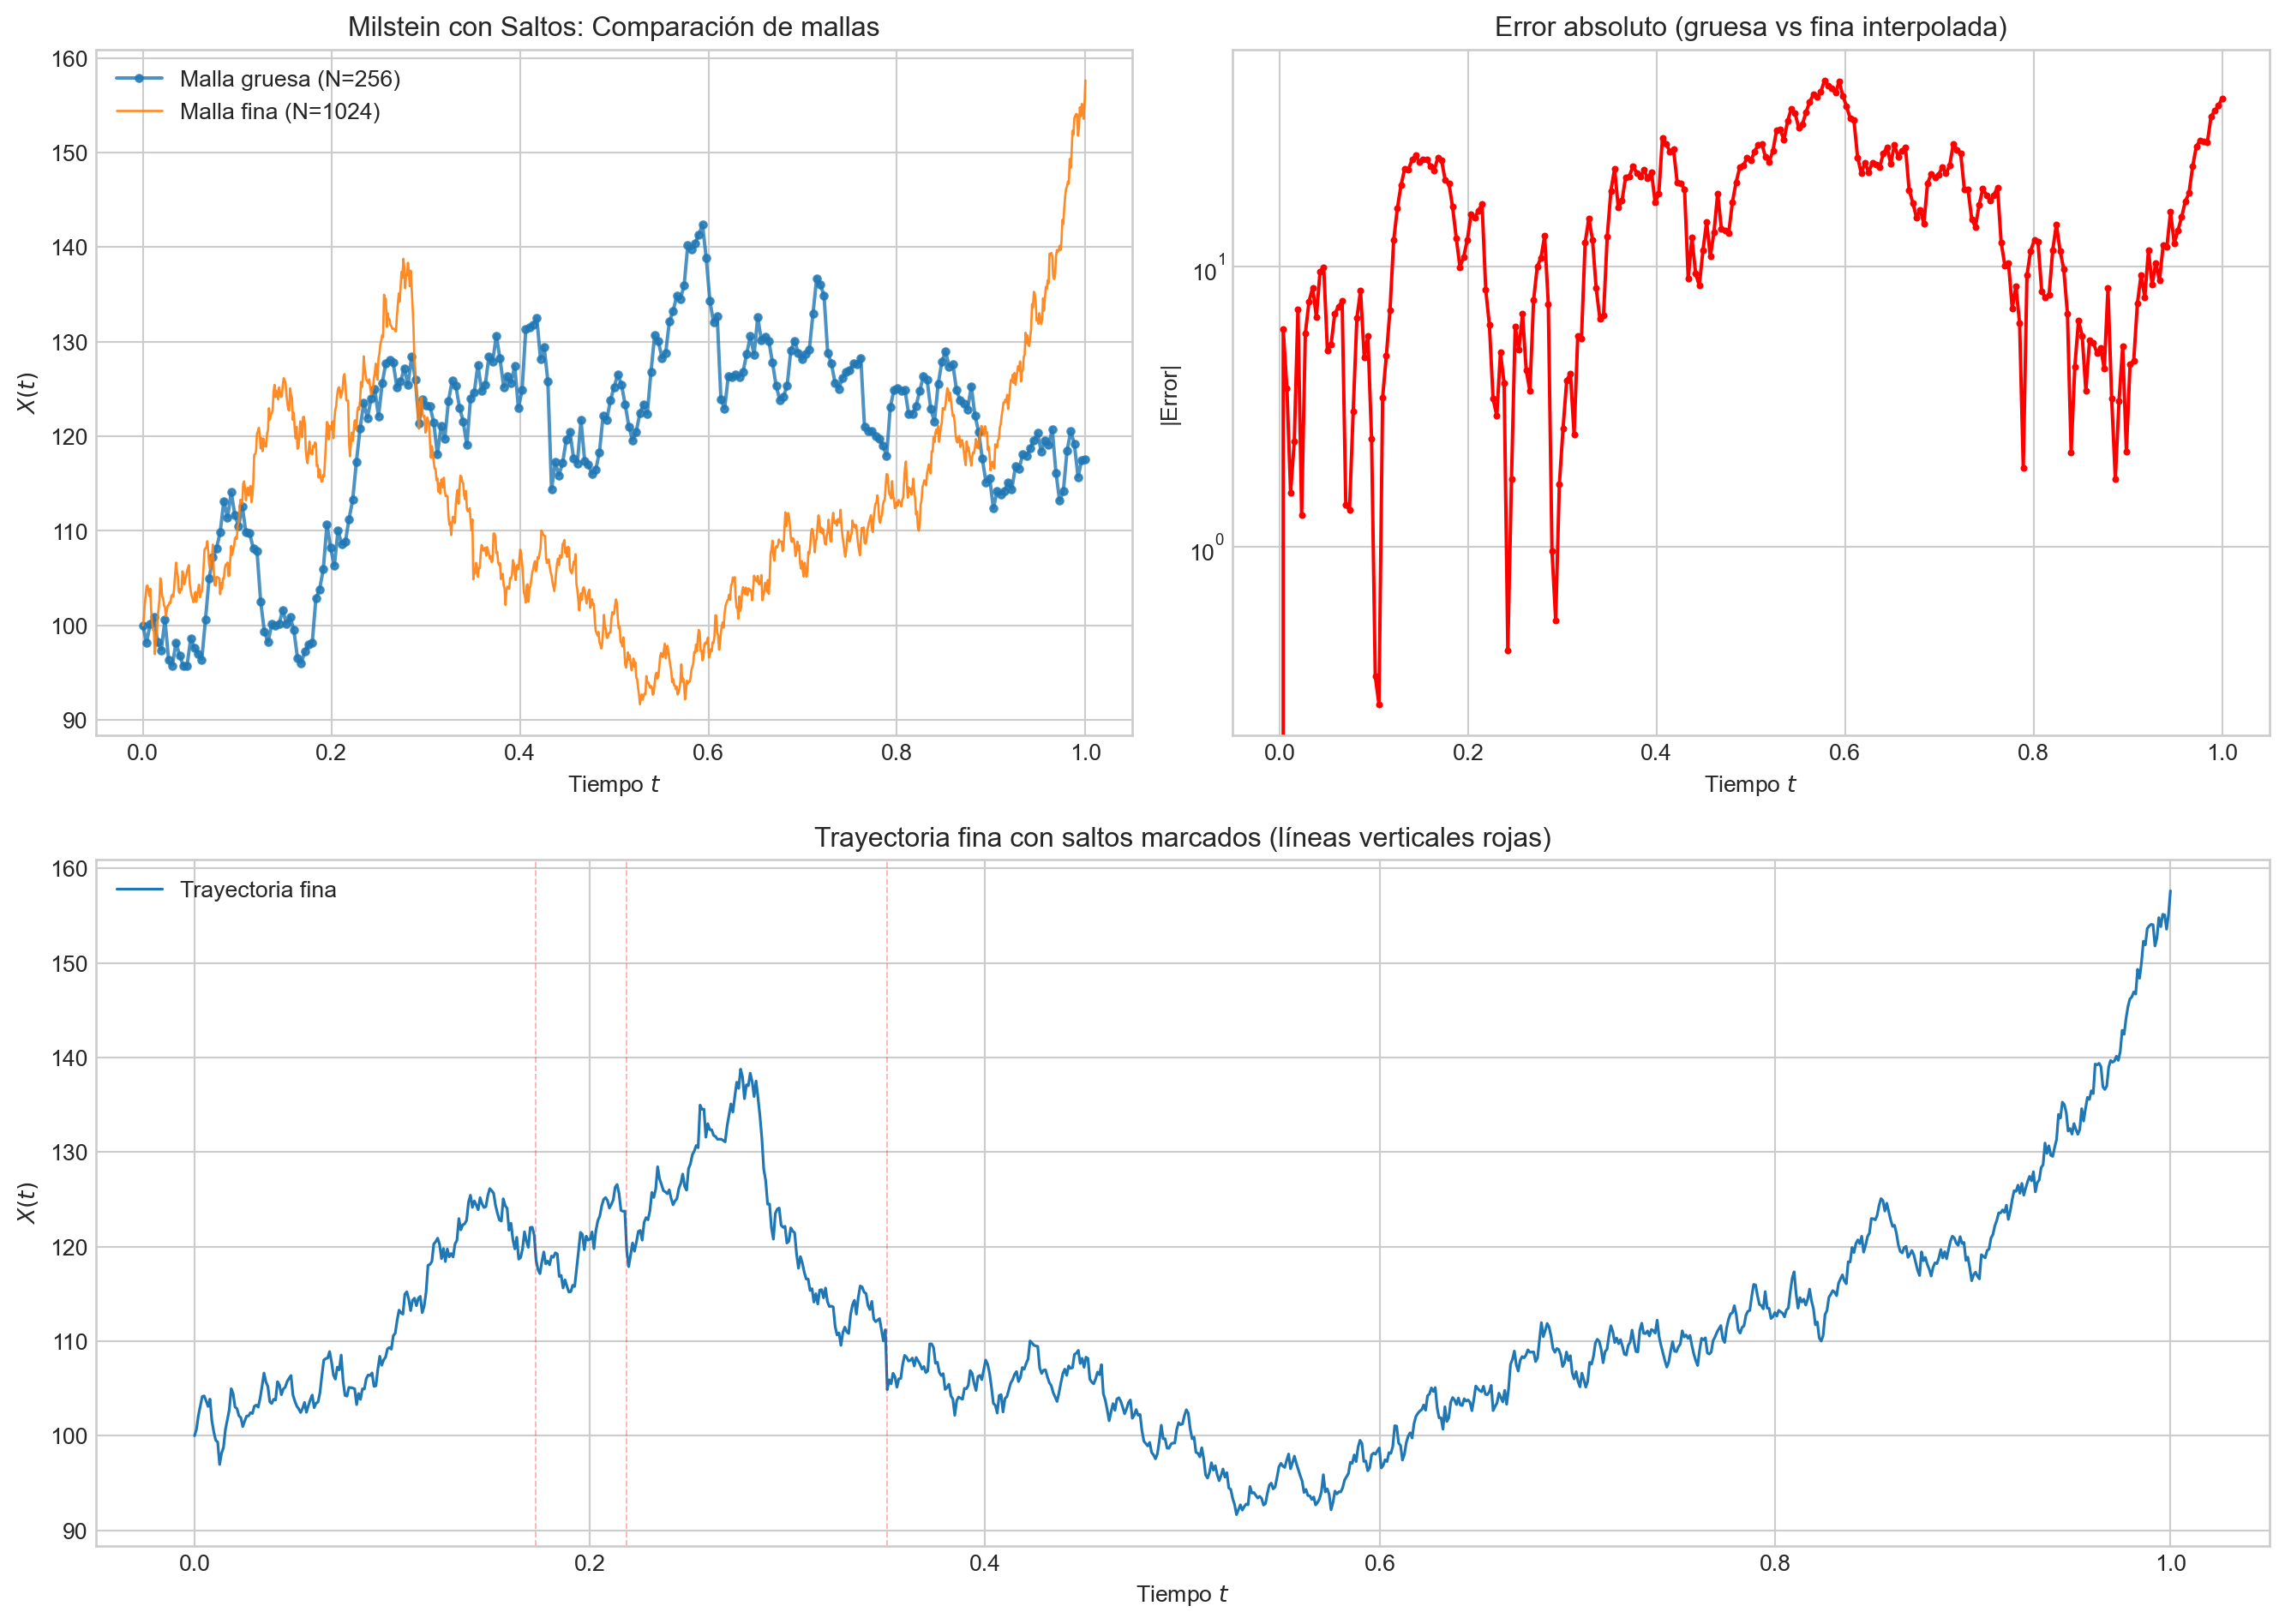
Código
"""Simulación y estimación corregida: semi-implícito compensado, M=1000.
Incluye severidad detectada, bootstrap por trayectoria B=1000, censura,
intensidad kernel circular y diagnóstico time-rescaling con bootstrap.
"""
import os, json
import numpy as np, pandas as pd
from scipy import stats
from scipy.stats import truncnorm
from scipy.optimize import minimize
from scipy.special import gammaln
from sklearn.mixture import GaussianMixture

SEED=2026; np.random.seed(SEED)
OUT='/mnt/data/salidas_saltos_final_1000'; os.makedirs(OUT,exist_ok=True)
M=1000; dt=1/365; T=2.; N=int(T/dt)
N_polizas=6800; prima=850.; tc=18.5; X0=500e6; delta=0.0015
infl=np.array([.52,.38,.38,.41,.45,.49,.55,.61,.58,.47,.42,.39,.35,.50,.37,.40,.44,.48,.53,.59,.56,.46,.41,.38])/100
# Calibración de la versión corregida del código cargado
lambda_m=6.; lambda_s=.15
season=np.array([.3,.3,.4,.6,1.,1.8,2.2,2.5,2.8,2.3,1.2,.5]); season/=season.mean()
mu_m,sig_m=12.5,1.; mu_s,sig_s=1_742_000.,875_000.
a=(0-mu_s)/sig_s
EY_m=np.exp(mu_m+.5*sig_m**2); EY_s=truncnorm.mean(a,np.inf,loc=mu_s,scale=sig_s)
r_month=np.array([.606,.602,.600,.597,.593,.589,.586,.582,.578,.574,.570,.566,.562,.559,.555,.551,.547,.543,.539,.535,.532,.528,.524,.520])/100
sig_month=np.array([.44,.47,.50,.53,.59,.74,.89,1.34,1.19,.98,.74,.68,.65,.60,.58,.60,.65,.74,.89,.82,.95,.86,.74,.68])/100
g=infl+delta; cum=np.cumsum(g); c_month=np.round(prima*np.exp(cum)*N_polizas/tc,2)
months=np.arange(24); tm=np.arange(N)*dt*12
r=np.interp(tm,months,r_month); sig=np.interp(tm,months,sig_month); c=np.interp(tm,months,c_month)
assert np.min(1-r*dt)>0

# Simulación semi-implícita compensada
U=np.zeros((M,N+1)); U[:,0]=X0; oracle=[]
for m in range(M):
  for n in range(N):
    month=int(tm[n])%12
    lm_day=lambda_m/365*season[month]; ls_day=lambda_s/365
    nm=np.random.poisson(lm_day); ns=np.random.poisson(ls_day); J=0.
    if nm:
      ym=np.exp(np.random.normal(mu_m,sig_m,nm)); J+=ym.sum()
      oracle.extend((m,n+1,'meteo',float(y)) for y in ym)
    if ns:
      ys=truncnorm.rvs(a,np.inf,loc=mu_s,scale=sig_s,size=ns); J+=ys.sum()
      oracle.extend((m,n+1,'sismo',float(y)) for y in ys)
    comp=lm_day*EY_m+ls_day*EY_s
    dW=np.sqrt(dt)*np.random.randn()
    U[m,n+1]=(U[m,n]*(1+sig[n]*dW)+c[n]*dt+comp*dt-J)/(1-r[n]*dt)

# Bipower variation agrupada
ret=(U[:,1:]-U[:,:-1])/U[:,:-1]
K=int(np.sqrt(N)); ar=np.abs(ret); P=ar[:,:-1]*ar[:,1:]; cs=np.cumsum(P,axis=1); cs=np.hstack([np.zeros((M,1)),cs])
sq=np.zeros(N)
for n in range(K,N): sq[n]=(np.pi/2)*(cs[:,n]-cs[:,n-K]).sum()/(K*M*dt)
sq[:K]=sq[K]; sigma_hat=np.sqrt(np.maximum(sq,1e-18))
# 3) Residuo corregido y umbral
alpha,varpi=3.5,.45
e=ret-(c[None,:]/U[:,:-1]+r[None,:])*dt
tau=alpha*sigma_hat*dt**varpi; D=np.abs(e)>tau; Y=-e*U[:,:-1]; valid=D&(Y>0)&np.isfinite(Y)
rows=[]
for m in range(M):
  for n in np.flatnonzero(valid[m]): rows.append((m,n+1,(n+1)*dt*365,Y[m,n],np.log(Y[m,n])))
df=pd.DataFrame(rows,columns=['sim','step','day','Y','logY']); odf=pd.DataFrame(oracle,columns=['sim','step','type','Y'])

# Mezcla en escala log, BIC k=2 vs k=3
x=df.logY.to_numpy(); fits={}
for k in (2,3): fits[k]=GaussianMixture(n_components=k,n_init=25,random_state=SEED+k).fit(x[:,None])
bic=pd.DataFrame([(k,fits[k].bic(x[:,None])) for k in fits],columns=['k','BIC']); kstar=int(bic.loc[bic.BIC.idxmin(),'k']); gm=fits[kstar]; order=np.argsort(gm.means_.ravel()); weights=gm.weights_[order]; means=gm.means_.ravel()[order]; sds=np.sqrt(gm.covariances_.reshape(-1))[order]
# Bootstrap B=1000 de los parámetros de mezcla, remuestreando trayectorias completas.
# Se conserva k=k* seleccionado por BIC y se ordenan componentes por mu_log.
B=1000
log_by=[df.loc[df.sim==i,'logY'].to_numpy() for i in range(M)]
boot_mix=[]
for b in range(B):
 ids=np.random.randint(0,M,M); z=[log_by[i] for i in ids if log_by[i].size]
 if not z: continue
 zb=np.concatenate(z)[:,None]
 if len(zb)<15: continue
 gb=GaussianMixture(n_components=kstar,n_init=1,max_iter=200,random_state=SEED+b).fit(zb)
 oo=np.argsort(gb.means_.ravel())
 boot_mix.append(np.r_[gb.weights_[oo],gb.means_.ravel()[oo],np.sqrt(gb.covariances_.reshape(-1))[oo]])
boot_mix=np.asarray(boot_mix)

# Bootstrap B=1000 por trayectoria, estadísticos de severidad
by=[df.loc[df.sim==i,'Y'].to_numpy() for i in range(M)]; boot_mean=np.empty(B); boot_med=np.empty(B); boot_n=np.empty(B)
for b in range(B):
 ids=np.random.randint(0,M,M); z=[by[i] for i in ids if by[i].size]; z=np.concatenate(z) if z else np.array([]); boot_mean[b]=z.mean() if z.size else np.nan; boot_med[b]=np.median(z) if z.size else np.nan; boot_n[b]=z.size
ci=lambda z:np.nanpercentile(z,[2.5,97.5])

bytime=[]; gaps=[]; cens=[]
for m in range(M):
 tt=(np.flatnonzero(valid[m])+1)*365*dt; bytime.append(tt)
 if len(tt)>1:gaps.extend(np.diff(tt))
 if len(tt):cens.append(730-tt[-1])
gaps=np.asarray(gaps); cens=np.asarray(cens); mean_gap=gaps.mean(); med_gap=np.median(gaps); cv2=gaps.var(ddof=1)/mean_gap**2
# Weibull/Gamma/Exponencial censurados; hiperexponencial censurada
def nllw(z):
 k,l=np.exp(z); return -((np.log(k)-k*np.log(l)+(k-1)*np.log(gaps)-(gaps/l)**k).sum()-(cens/l)**k).sum()*0
# corregir expresión anterior explícitamente
def nll_weib(z):
 k,l=np.exp(z); ll=((np.log(k)-k*np.log(l)+(k-1)*np.log(gaps)-(gaps/l)**k).sum())-((cens/l)**k).sum(); return -ll
def nll_gamma(z):
 a,s=np.exp(z); ll=((a-1)*np.log(gaps)-gaps/s-gammaln(a)-a*np.log(s)).sum()+stats.gamma.logsf(cens,a=a,scale=s).sum(); return -ll
rate=len(gaps)/(gaps.sum()+cens.sum()); rw=minimize(nll_weib,np.log([1.1,200]),method='L-BFGS-B'); kw,lw=np.exp(rw.x); rg=minimize(nll_gamma,np.log([2,100]),method='L-BFGS-B'); ag,sg=np.exp(rg.x)
def nll_h(z):
 w=1/(1+np.exp(-z[0])); l1,l2=np.exp(z[1:]); f=w*l1*np.exp(-l1*gaps)+(1-w)*l2*np.exp(-l2*gaps); S=w*np.exp(-l1*cens)+(1-w)*np.exp(-l2*cens); return -(np.log(f).sum()+np.log(S).sum())
best=None
for _ in range(25):
 rr=minimize(nll_h,[np.random.randn(),np.random.uniform(-5,-2),np.random.uniform(-5,-2)],method='L-BFGS-B')
 if rr.success and (best is None or rr.fun<best.fun):best=rr
wh=1/(1+np.exp(-best.x[0])); l1,l2=np.exp(best.x[1:]);
# scipy gammaln via scipy.special if needed
from scipy.special import gammaln
# recompute gamma safely
def nll_gamma2(z):
 a,s=np.exp(z); ll=((a-1)*np.log(gaps)-gaps/s-gammaln(a)-a*np.log(s)).sum()+stats.gamma.logsf(cens,a=a,scale=s).sum(); return -ll
rg=minimize(nll_gamma2,np.log([2,100]),method='L-BFGS-B'); ag,sg=np.exp(rg.x); llE=len(gaps)*np.log(rate)-rate*(gaps.sum()+cens.sum()); llW=-rw.fun; llG=-rg.fun; llH=-best.fun
aic=pd.DataFrame([('Exponencial',2-2*llE),('Weibull',4-2*llW),('Gamma',4-2*llG),('Hiperexponencial',6-2*llH)],columns=['Modelo','AIC']).sort_values('AIC')

# Intensidad acumulada agrupada y kernel circular; MSE 
Dgrid=np.arange(731.); Lam=np.zeros(731)
for tt in bytime: Lam+=np.searchsorted(tt,Dgrid,'right')
Lam/=M
grid=np.arange(365.); events=np.concatenate([np.mod(tt,365) for tt in bytime if len(tt)])
def kernel(grid,events,h):
 d=np.abs(grid[:,None]-events[None,:]); d=np.minimum(d,365-d); return np.exp(-.5*(d/h)**2).sum(1)/(np.sqrt(2*np.pi)*h*M)
# intensidad verdadera diaria: lambda_annual/365 * phi(month)+lambda_s/365
true_daily=np.array([lambda_m/365*season[int((d/30.4368))%12]+lambda_s/365 for d in grid])
win=[]
for h in [30,60,91,182]:
 lh=kernel(grid,events,h); win.append((h,np.mean((lh-true_daily)**2)))
win=pd.DataFrame(win,columns=['Ventana_dias','MSE']).sort_values('MSE'); hstar=int(win.iloc[0,0]); lamhat=kernel(grid,events,hstar)

# Time-rescaling
rgaps=[]
for tt in bytime:
 if len(tt)>1:rgaps.extend(np.diff(np.interp(tt,Dgrid,Lam)))
rgaps=np.asarray(rgaps); u=1-np.exp(-rgaps); us=np.sort(u); ec=(np.arange(1,len(us)+1)-.5)/len(us); Dobs=np.max(np.abs(us-ec)) if len(us) else np.nan
Db=np.empty(B)
for b in range(B):
 vals=[]
 for m in np.random.randint(0,M,M):
  tt=bytime[m]
  if len(tt)>1: vals.extend((1-np.exp(-np.diff(np.interp(tt,Dgrid,Lam)))).tolist())
 q=np.sort(vals); ecq=(np.arange(1,len(q)+1)-.5)/len(q); Db[b]=np.max(np.abs(q-ecq))
pboot=np.mean(Db>=Dobs)


mix_boot_ci=np.nanpercentile(boot_mix,[2.5,97.5],axis=0)
mix_boot_est=np.nanmedian(boot_mix,axis=0)
summary={'M':M,'dt':dt,'T_years':T,'seed':SEED,'K_bipower':K,'alpha':alpha,'varpi':varpi,'EY_meteo':EY_m,'EY_sismo':EY_s,'oracle_events':len(odf),'detected_valid':len(df),'detection_rate':len(df)/len(odf),'mean_detected':df.Y.mean(),'median_detected':df.Y.median(),'mean_CI95':ci(boot_mean).tolist(),'median_CI95':ci(boot_med).tolist(),'n_complete_gaps':len(gaps),'n_censored':len(cens),'mean_gap_days':mean_gap,'median_gap_days':med_gap,'CV2':cv2,'rescaling_D':Dobs,'rescaling_bootstrap_p':pboot,'selected_bandwidth':hstar}
json.dump(summary,open(OUT+'/summary.json','w'),indent=2)
bic.to_csv(OUT+'/BIC_mezcla.csv',index=False); aic.to_csv(OUT+'/AIC_tiempos_censurados.csv',index=False); win.to_csv(OUT+'/MSE_ventanas.csv',index=False)
pd.DataFrame({'componente':np.arange(1,kstar+1),'peso':weights,'mu_log':means,'sigma_log':sds,'media_lineal_USD':np.exp(means+.5*sds**2)}).to_csv(OUT+'/mezcla_severidad.csv',index=False)
ci_mix_rows=[]

for j in range(kstar):
 ci_mix_rows.append({'componente':j+1,'peso_est':weights[j],'peso_IC95_inf':mix_boot_ci[0,j],'peso_IC95_sup':mix_boot_ci[1,j],'mu_log_est':means[j],'mu_log_IC95_inf':mix_boot_ci[0,kstar+j],'mu_log_IC95_sup':mix_boot_ci[1,kstar+j],'sigma_log_est':sds[j],'sigma_log_IC95_inf':mix_boot_ci[0,2*kstar+j],'sigma_log_IC95_sup':mix_boot_ci[1,2*kstar+j]})
pd.DataFrame(ci_mix_rows).to_csv(OUT+'/mezcla_bootstrap_IC95.csv',index=False)
pd.DataFrame([summary]).to_csv(OUT+'/resumen_principal.csv',index=False)
np.savez_compressed(OUT+'/resultados.npz',U=U,sigma_hat=sigma_hat,e_tilde=e,tau=tau,valid=valid,Y_hat=Y,Lambda_hat=Lam,gaps=gaps,censored=cens,u_rescaled=u,D_boot=Db,lambda_true_daily=true_daily,lambda_hat_daily=lamhat)

import matplotlib.pyplot as plt

plt.figure(figsize=(8,5)); plt.hist(x,bins=50,density=True,alpha=.6); xx=np.linspace(x.min(),x.max(),500); plt.plot(xx,sum(w*stats.norm.pdf(xx,m,s) for w,m,s in zip(weights,means,sds)),lw=2); plt.xlabel(r'$\log(\widehat Y)$');plt.ylabel('Densidad');plt.title('Severidades detectadas y mezcla ajustada');plt.tight_layout();plt.savefig(OUT+'/01_severidad_mezcla.png',dpi=200);plt.close()

plt.figure(figsize=(8,5));plt.hist(gaps,bins=50,density=True,alpha=.6,label='Gaps completos');xg=np.linspace(.1,np.quantile(gaps,.995),500);plt.plot(xg,rate*np.exp(-rate*xg),label='Exponencial');plt.plot(xg,stats.weibull_min.pdf(xg,kw,scale=lw),label='Weibull');plt.plot(xg,stats.gamma.pdf(xg,a=ag,scale=sg),label='Gamma');plt.plot(xg,wh*l1*np.exp(-l1*xg)+(1-wh)*l2*np.exp(-l2*xg),label='Hiperexponencial');plt.legend();plt.xlabel(r'$\Delta\tau$ (días)');plt.ylabel('Densidad');plt.title('Tiempos entre saltos detectados');plt.tight_layout();plt.savefig(OUT+'/02_tiempos.png',dpi=200);plt.close()

plt.figure(figsize=(9,5));plt.plot(grid,true_daily*365,label='Intensidad generadora');plt.plot(grid,lamhat*365,label=f'Kernel circular h={hstar} días');plt.xlabel('Día del año');plt.ylabel('Eventos/año');plt.title('Intensidad estacional detectada vs. generadora');plt.legend();plt.tight_layout();plt.savefig(OUT+'/03_intensidad.png',dpi=200);plt.close()

plt.figure(figsize=(6,6));plt.plot(ec,us,'.',ms=2);plt.plot([0,1],[0,1],lw=2);plt.xlabel('Uniforme teórica');plt.ylabel('Reescalado');plt.title('P-P del time-rescaling (diagnóstico)');plt.tight_layout();plt.savefig(OUT+'/04_time_rescaling.png',dpi=200);plt.close()

#print(json.dumps(summary,indent=2,ensure_ascii=False)); 
#print('\nMEZCLA\n',pd.read_csv(OUT+'/mezcla_severidad.csv').to_string(index=False)); #print('\nBIC\n',bic.to_string(index=False)); 
# print('\nAIC\n',aic.to_string(index=False)); 
# print('\nMSE\n',win.to_string(index=False))
Código
import plotly.graph_objects as go

fig = go.Figure()

fig.add_trace(
    go.Scatter(
        x=sev_x,
        y=sev_F,
        mode="lines",
        line=dict(
            width=2.5,
            shape="hv"
        ),
        name="ECDF",
        hovertemplate=(
            "Severidad: %{x:,.2f} USD<br>"
            "F empírica: %{y:.4f}"
            "<extra></extra>"
        )
    )
)

fig.update_layout(
    title="Milstein Compensado: función de distribución empírica de severidades",
    xaxis_title="Severidad detectada (USD)",
    yaxis_title="F empírica",
    yaxis=dict(
        range=[0, 1.02]
    ),
    template="plotly_white",
    hovermode="x",
    width=800,
    height=500,
    margin=dict(
        l=80,
        r=70,
        t=150,
        b=100 
        )
)

fig.show()
Figura 8.3: Función de distribución empírica de las severidades detectadas mediante el método de Milstein Compensado.
Código
import plotly.graph_objects as go

fig = go.Figure()

fig.add_trace(
    go.Scatter(
        x=sev_x,
        y=sev_F,
        mode="lines",
        line=dict(
            width=2.5,
            shape="hv"
        ),
        name="F empírica",
        hovertemplate=(
            "Severidad: %{x:,.2f} USD<br>"
            "F empírica: %{y:.4f}"
            "<extra></extra>"
        )
    )
)

fig.update_layout(
    title=dict(
        text=(
            "Semi-Implícito Compensado: "
            "función de distribución empírica de severidades"
        ),
        x=0.5,
        xanchor="center"
    ),

    xaxis=dict(
        title="Severidad detectada (USD)",
        tickformat="~s",
        showgrid=True
    ),

    yaxis=dict(
        title="F empírica",
        range=[0, 1.02],
        showgrid=True
    ),

    template="plotly_white",

    width=900,
    height=550,

    hovermode="x unified",

    margin=dict(
        l=90,
        r=70,
        t=130,
        b=100
    )
)

fig.show()
Figura 8.4: Función de distribución empírica de las severidades detectadas mediante el esquema Semi-Implícito Compensado.

8.6.4 Estimación de densidad mediante KDE

Para representar suavemente la densidad de severidad, el programa transforma la variable mediante

\[Z=\log(Y), \tag{8.10}\]

y estima la densidad de \(Z\) mediante un estimador de núcleo. La transformación inversa requiere incorporar el jacobiano correspondiente,

\[\widehat{f}_{Y,q}(y) = \frac{1}{y} \widehat{f}_{Z,q}(\log y), \qquad y>0. \tag{8.11}\]

La utilización de métodos de núcleo para estimación no paramétrica de densidades se encuentra establecida en (Silverman 1986).

A partir del conjunto agregado de severidades de los saltos detectados en las \((1000)\) trayectorias simuladas mediante cada uno de los esquemas numéricos, se obtuvo una estimación no paramétrica de la densidad de severidad mediante el método de estimación por núcleos (Kernel Density Estimation, KDE). La estimación se construyó directamente a partir de las observaciones detectadas, sin imponer una familia paramétrica para la distribución subyacente. En las figuras correspondientes, el histograma representa la distribución empírica de las severidades en términos de densidad, mientras que la curva suavizada corresponde a \(\widehat f_Y(y)\). La forma obtenida permite identificar las regiones de mayor concentración de severidades y observar el comportamiento de la cola derecha de la muestra

Código
import plotly.graph_objects as go

fig = go.Figure()

# Histograma de severidades detectadas
fig.add_trace(
    go.Histogram(
        x=severidades,
        histnorm="probability density",
        nbinsx=45,
        opacity=0.55,
        name="Severidades detectadas",
        hovertemplate=(
            "Intervalo: %{x}<br>"
            "Densidad: %{y:.3e}"
            "<extra></extra>"
        )
    )
)

# KDE agregada
fig.add_trace(
    go.Scatter(
        x=grid_y,
        y=dens_y,
        mode="lines",
        line=dict(width=2.5),
        name="KDE agregada",
        hovertemplate=(
            "Severidad: %{x:,.2f} USD<br>"
            "Densidad KDE: %{y:.3e}"
            "<extra></extra>"
        )
    )
)

fig.update_layout(
    title="Milstein Compensado: distribución agregada de severidades detectadas",
    xaxis_title="Severidad detectada (USD)",
    yaxis_title="Densidad",
    template="plotly_white",
    hovermode="x unified",
    legend=dict(
        orientation="h",
        yanchor="bottom",
        y=1.02,
        xanchor="right",
        x=1
    ),
    width=800,
    height=500,
    margin=dict(
        l=80,
        r=70,
        t=150,
        b=100 
        )
)

fig.show()
Figura 8.5: Estimación no paramétrica de la densidad de las severidades de los saltos detectados en las trayectorias generadas mediante el esquema Milstein Compensado.
Figura 8.6: Estimación no paramétrica de la densidad de las severidades de los saltos detectados en las trayectorias generadas mediante el esquema Semi-Implícito Compensado.

8.6.5 Ajustes paramétricos auxiliares

Como complemento descriptivo de la estimación no paramétrica se ajustaron las familias Lognormal, Gamma y Weibull. Estos modelos no sustituyen la ECDF ni la KDE; se emplean para disponer de representaciones paramétricas comparables mediante máxima verosimilitud y el criterio de información de Akaike,

\[AIC=2k-2\widehat{\ell}, \tag{8.12}\]

donde \(k\) es el número de parámetros estimados y \(\widehat{\ell}\) es la log-verosimilitud maximizada. El AIC se utiliza únicamente para comparar las tres familias implementadas en el programa (Akaike 1974).

Ajustes paramétricos auxiliares de severidad: Milstein compensado.
Familia Milstein: logLik Milstein: AIC Parámetros
Lognormal -21,197.836650 42,399.673300 \(\mu_{\log}=14.276370\), \(\sigma_{\log}=0.454640\)
Gamma -21,350.264824 42,704.529647 shape \(=4.223838\), scale \(=424,491.405\)
Weibull -21,572.054840 43,148.109681 shape \(=1.664944\), scale \(=2,020,400.435\)
Ajustes paramétricos auxiliares de severidad: Semi-Implícito compensado.
Familia Semi-Implícito: logLik Semi-Implícito: AIC Parámetros
Lognormal -21,197.860641 42,399.721281 \(\mu_{\log}=14.276395\), \(\sigma_{\log}=0.454636\)
Gamma -21,350.286911 42,704.573822 shape \(=4.223916\), scale \(=424,493.379\)
Weibull -21,572.080175 43,148.160350 shape \(=1.664955\), scale \(=2,020,447.324\)

En ambos esquemas la familia Lognormal presenta el menor AIC dentro del conjunto de tres familias consideradas. La diferencia de AIC respecto de Gamma es aproximadamente \(304.86\), mientras que respecto de Weibull es aproximadamente \(748.44\).

8.6.6 Distribución de los tiempos entre detecciones

Los tiempos entre detecciones se calculan exclusivamente dentro de cada trayectoria. Si

\[\tau_1^{(j)}<\tau_2^{(j)}<\cdots<\tau_{K_j}^{(j)} \tag{8.13}\]

son los tiempos detectados en la trayectoria \(j\), los gaps completos se definen mediante

\[\Delta\tau_k^{(j)} = \tau_k^{(j)} - \tau_{k-1}^{(j)}, \qquad k=2,\ldots,K_j. \tag{8.14}\]

En la realización estudiada se obtuvieron 673 gaps completos y 749 observaciones censuradas al final del horizonte de observación.

Estadísticos descriptivos de los tiempos entre detecciones.
Estadístico Milstein compensado Semi-Implícito compensado
Gaps completos 673 673
Censuras terminales 749 749
Media (días) 196.5973 196.5973
Mediana (días) 147 147
\(CV^2\) 0.677208 0.677208

El coeficiente de variación cuadrático se calcula mediante

\[CV^2 = \frac{\operatorname{Var}(\Delta\tau)} {\left[\mathbb{E}(\Delta\tau)\right]^2}. \tag{8.15}\]

El valor \(CV^2=0.677208\) es inferior a uno. Esta observación es puramente descriptiva: no constituye por sí misma una prueba de un proceso de Poisson ni permite ignorar la censura o la posible dependencia entre detecciones.

Código
import plotly.graph_objects as go

fig = go.Figure()

fig.add_trace(
    go.Histogram(
        x=gaps_completos,
        histnorm="probability density",
        nbinsx=40,
        opacity=0.60,
        name="Gaps completos",
        hovertemplate=(
            "Tiempo entre detecciones: %{x:.2f} días<br>"
            "Densidad: %{y:.5f}"
            "<extra></extra>"
        )
    )
)

fig.update_layout(
    title="Milstein Compensado: gaps completos (descriptivo)",
    xaxis_title="Días entre detecciones consecutivas",
    yaxis_title="Densidad",
    template="plotly_white",
    hovermode="x",
    width=700,
    height=400
)

fig.show()
Figura 8.7: Distribución descriptiva de los tiempos completos entre detecciones consecutivas para el método de Milstein Compensado.
Código
import plotly.graph_objects as go

fig = go.Figure()

fig.add_trace(
    go.Histogram(
        x=gaps_completos,
        histnorm="probability density",
        nbinsx=40,
        opacity=0.65,
        name="Gaps completos",
        hovertemplate=(
            "Tiempo entre detecciones: %{x:.1f} días<br>"
            "Densidad: %{y:.5f}"
            "<extra>Gaps completos</extra>"
        )
    )
)

fig.update_layout(
    title=dict(
        text=(
            "Semi-Implícito Compensado: "
            "gaps completos entre detecciones"
        ),
        x=0.5,
        xanchor="center"
    ),

    xaxis=dict(
        title="Días entre detecciones consecutivas",
        showgrid=True,
        zeroline=False
    ),

    yaxis=dict(
        title="Densidad",
        showgrid=True,
        zeroline=False
    ),

    template="plotly_white",

    width=900,
    height=550,

    hovermode="x",

    legend=dict(
        orientation="h",
        yanchor="bottom",
        y=1.02,
        xanchor="right",
        x=1
    ),

    margin=dict(
        l=90,
        r=70,
        t=130,
        b=100
    ),

    bargap=0.03
)

fig.show()
Figura 8.8: Distribución descriptiva de los tiempos completos entre detecciones consecutivas para el esquema Semi-Implícito Compensado.

8.6.6.1 Censura administrativa y verosimilitud

Si una trayectoria presenta una última detección en \(\tau_{K_j}^{(j)}\) y no se observa una detección posterior antes de \(T\), el tiempo hasta el siguiente evento es desconocido. La información disponible es que dicho tiempo excede la duración restante

\[C^{(j)} = T-\tau_{K_j}^{(j)}. \tag{8.16}\]

La verosimilitud paramétrica utiliza la contribución de densidad para los intervalos completos y la función de supervivencia para las observaciones censuradas,

\[\ell_q(\theta) = \sum_{\mathrm{completos}} \log f(\Delta\tau;\theta) + \sum_{\mathrm{censurados}} \log S(C;\theta). \tag{8.17}\]

Este tratamiento corresponde a la formulación estándar de inferencia con censura por la derecha en procesos de conteo y análisis de supervivencia (Aalen 1978; Andersen et al. 1993; Kaplan y Meier 1958).

Código
import numpy as np
import plotly.graph_objects as go
from scipy import stats

fig = go.Figure()

# ---------------------------------------------------------
# Kaplan-Meier
# ---------------------------------------------------------

fig.add_trace(
    go.Scatter(
        x=km["tiempo_dias"],
        y=km["S_KM"],
        mode="lines",
        line=dict(
            width=2.5,
            shape="hv"
        ),
        name="Kaplan-Meier",
        hovertemplate=(
            "Tiempo: %{x:.2f} días<br>"
            "Supervivencia: %{y:.4f}"
            "<extra></extra>"
        )
    )
)

# ---------------------------------------------------------
# Supervivencias paramétricas 
# ---------------------------------------------------------

if pars_t:

    xmax = max(
        np.max(gaps_completos) if len(gaps_completos) else 1,
        np.max(censurados) if len(censurados) else 1
    )

    xx = np.linspace(0, xmax, 500)

    # Exponencial
    p = pars_t["Exponencial"]

    fig.add_trace(
        go.Scatter(
            x=xx,
            y=np.exp(-p["rate"] * xx),
            mode="lines",
            line=dict(width=2),
            name="Exponencial (censurada)",
            hovertemplate=(
                "Tiempo: %{x:.2f} días<br>"
                "S(t): %{y:.4f}"
                "<extra>Exponencial</extra>"
            )
        )
    )

    # Weibull
    p = pars_t["Weibull"]

    fig.add_trace(
        go.Scatter(
            x=xx,
            y=stats.weibull_min.sf(
                xx,
                p["shape"],
                scale=p["scale"]
            ),
            mode="lines",
            line=dict(width=2),
            name="Weibull (censurada)",
            hovertemplate=(
                "Tiempo: %{x:.2f} días<br>"
                "S(t): %{y:.4f}"
                "<extra>Weibull</extra>"
            )
        )
    )

    # Gamma
    p = pars_t["Gamma"]

    fig.add_trace(
        go.Scatter(
            x=xx,
            y=stats.gamma.sf(
                xx,
                p["shape"],
                scale=p["scale"]
            ),
            mode="lines",
            line=dict(width=2),
            name="Gamma (censurada)",
            hovertemplate=(
                "Tiempo: %{x:.2f} días<br>"
                "S(t): %{y:.4f}"
                "<extra>Gamma</extra>"
            )
        )
    )

fig.update_layout(
    title="Milstein Compensado: supervivencia de los tiempos entre detecciones",
    xaxis_title="Tiempo entre detecciones (días)",
    yaxis_title="Supervivencia",
    yaxis=dict(
        range=[0, 1.02]
    ),
    template="plotly_white",
    hovermode="x unified",
    width=800,
    height=500,
    legend=dict(
        orientation="h",
        yanchor="bottom",
        y=1.02,
        xanchor="right",
        x=1
    ),
    margin=dict(
        l=80,
        r=70,
        t=150,
        b=100 
        )
)

fig.show()
Figura 8.9: Función de supervivencia Kaplan–Meier y ajustes paramétricos auxiliares para los tiempos entre detecciones mediante Milstein Compensado.
Código
import plotly.graph_objects as go
import numpy as np

fig = go.Figure()

# ------------------------------------------------------------------
# Kaplan-Meier
# ------------------------------------------------------------------

fig.add_trace(
    go.Scatter(
        x=km["tiempo_dias"],
        y=km["S_KM"],
        mode="lines",
        line=dict(
            width=3,
            shape="hv"
        ),
        name="Kaplan-Meier",
        hovertemplate=(
            "Tiempo: %{x:.2f} días<br>"
            "Supervivencia: %{y:.4f}"
            "<extra>Kaplan-Meier</extra>"
        )
    )
)

# ------------------------------------------------------------------
# Curvas ajustadas
# ------------------------------------------------------------------

if pars_t:

    xmax = max(
        np.max(gaps_completos)
        if len(gaps_completos) else 1,

        np.max(censurados)
        if len(censurados) else 1
    )

    xx = np.linspace(0, xmax, 500)

    # --------------------------------------------------------------
    # Exponencial
    # --------------------------------------------------------------

    p = pars_t["Exponencial"]

    S_exp = np.exp(
        -p["rate"] * xx
    )

    fig.add_trace(
        go.Scatter(
            x=xx,
            y=S_exp,
            mode="lines",
            line=dict(width=2.5),
            name="Exponencial (censurada)",
            hovertemplate=(
                "Tiempo: %{x:.2f} días<br>"
                "Supervivencia: %{y:.4f}"
                "<extra>Exponencial</extra>"
            )
        )
    )

    # --------------------------------------------------------------
    # Weibull
    # --------------------------------------------------------------

    p = pars_t["Weibull"]

    S_weibull = (
        np.exp(
            -(
                xx / p["scale"]
            ) ** p["shape"]
        )
    )

    fig.add_trace(
        go.Scatter(
            x=xx,
            y=S_weibull,
            mode="lines",
            line=dict(width=2.5),
            name="Weibull (censurada)",
            hovertemplate=(
                "Tiempo: %{x:.2f} días<br>"
                "Supervivencia: %{y:.4f}"
                "<extra>Weibull</extra>"
            )
        )
    )

    # --------------------------------------------------------------
    # Gamma
    # --------------------------------------------------------------

    # Se utiliza scipy solamente para reproducir exactamente
    # la supervivencia Gamma que ya estaba calculada en el código.
    from scipy import stats

    p = pars_t["Gamma"]

    S_gamma = stats.gamma.sf(
        xx,
        p["shape"],
        scale=p["scale"]
    )

    fig.add_trace(
        go.Scatter(
            x=xx,
            y=S_gamma,
            mode="lines",
            line=dict(width=2.5),
            name="Gamma (censurada)",
            hovertemplate=(
                "Tiempo: %{x:.2f} días<br>"
                "Supervivencia: %{y:.4f}"
                "<extra>Gamma</extra>"
            )
        )
    )

# ------------------------------------------------------------------
# Configuración
# ------------------------------------------------------------------

fig.update_layout(
    title=dict(
        text=(
            "Semi-Implícito Compensado: "
            "supervivencia de los tiempos entre detecciones"
        ),
        x=0.5,
        xanchor="center"
    ),

    xaxis=dict(
        title="Tiempo entre detecciones (días)",
        showgrid=True,
        zeroline=False
    ),

    yaxis=dict(
        title="Supervivencia",
        range=[0, 1.02],
        showgrid=True
    ),

    template="plotly_white",

    width=900,
    height=550,

    hovermode="x unified",

    legend=dict(
        orientation="h",
        yanchor="bottom",
        y=1.02,
        xanchor="right",
        x=1
    ),

    margin=dict(
        l=90,
        r=70,
        t=150,
        b=100
    )
)

fig.show()
Figura 8.10: Función de supervivencia Kaplan–Meier y ajustes paramétricos auxiliares para los tiempos entre detecciones mediante del esquema Semi-Implícito Compensado.

8.6.6.2 Ajustes paramétricos auxiliares para los tiempos

El programa ajusta exclusivamente las familias Exponencial, Weibull y Gamma utilizando la verosimilitud censurada de Ecuación 8.17. Para el caso homogéneo de un proceso de Poisson con intensidad constante \(\lambda\), los tiempos entre eventos presentan distribución Exponencial. Sin embargo, la sola comparación con una familia Exponencial no implica que el proceso de detecciones sea homogéneo (Andersen et al. 1993).

Ajustes temporales censurados: Milstein compensado.
Familia Milstein: logLik Milstein: AIC Parámetros
Exponencial -4,832.743080 9,667.486161 rate \(=0.002068509\)
Weibull -4,832.116455 9,668.232911 shape \(=1.036538\), scale \(=476.216322\)
Gamma -4,832.237563 9,668.475126 shape \(=1.043957\), scale \(=454.015731\)
Ajustes temporales censurados: Semi-Implícito compensado.
Familia Semi-Implícito: logLik Semi-Implícito: AIC Parámetros
Exponencial -4,832.743080 9,667.486161 rate \(=0.002068509\)
Weibull -4,832.116455 9,668.232911 shape \(=1.036538\), scale \(=476.216322\)
Gamma -4,832.237563 9,668.475126 shape \(=1.043957\), scale \(=454.015731\)

La Exponencial presenta el menor AIC en ambos esquemas. La diferencia respecto de Weibull es aproximadamente \(0.747\) y respecto de Gamma aproximadamente \(0.989\). Las diferencias son pequeñas en escala absoluta de AIC; por ello, el resultado debe interpretarse como una comparación dentro del conjunto de familias implementadas y no como una identificación concluyente de la ley generadora de los tiempos.

8.6.6.3 Bootstrap de los tiempos

La incertidumbre de las estadísticas temporales se obtiene mediante bootstrap por trayectoria. Los intervalos percentiles reportados por el programa son

Intervalos bootstrap de los estadísticos de los tiempos entre detecciones.
Estadístico Milstein compensado Semi-Implícito compensado
Media, IC 95 % (días) [185.419; 209.735] [185.419; 209.735]
Mediana, IC 95 % (días) [132.000; 166.512] [132.000; 166.512]
\(CV^2\), IC 95 % [0.6108; 0.7445] [0.6108; 0.7445]

8.6.7 Estimación de la intensidad estacional de las detecciones

La intensidad se estima mediante un kernel gaussiano circular anual. Para un día del año \(t\) y tiempos de detección \(\tau_k^{(j)}\), se utiliza una distancia circular con periodo anual de 365 días y se consideran los anchos de banda

\[b\in\{30,60,91,182\}\text{días}. \tag{8.18}\]

La estimación mediante funciones núcleo pertenece al marco no paramétrico de estimación de intensidades de procesos de puntos (Ramlau-Hansen 1983). El programa conserva las cuatro curvas y utiliza \(b=30\) días como referencia gráfica.

Sensibilidad de la intensidad estimada al ancho de banda para las detecciones.
Ancho de banda \(b\) (días) Mínimo Máximo Media
30 0.002372 0.005481 0.003896
60 0.002897 0.004835 0.003887
91 0.003188 0.004258 0.003721
182 0.002555 0.002777 0.002665
Código
import plotly.graph_objects as go

fig = go.Figure()

for bw in bandwidths:

    fig.add_trace(
        go.Scatter(
            x=grid_doy,
            y=intensidades[bw],
            mode="lines",
            line=dict(width=2.5),
            name=f"b={bw} días",
            hovertemplate=(
                "Día del año: %{x:.1f}<br>"
                "Intensidad: %{y:.6f}"
                f"<extra>b={bw} días</extra>"
            )
        )
    )

fig.update_layout(
    title="Milstein Compensado: sensibilidad del suavizado de intensidad",
    xaxis_title="Día del año",
    yaxis_title=(
        "Intensidad estimada de detecciones "
        "por trayectoria y día"
    ),
    template="plotly_white",
    hovermode="x unified",
    width=800,
    height=500,
    legend=dict(
        orientation="h",
        yanchor="bottom",
        y=1.02,
        xanchor="right",
        x=1
    ),
    margin=dict(
        l=80,
        r=70,
        t=150,
        b=100 
        )
)

fig.show()
Figura 8.11: Sensibilidad de la intensidad estimada de detecciones respecto al ancho de banda para Milstein Compensado.
Código
import plotly.graph_objects as go

fig = go.Figure()

for bw in bandwidths:

    fig.add_trace(
        go.Scatter(
            x=grid_doy,
            y=intensidades[bw],
            mode="lines",
            line=dict(width=2.5),
            name=f"b={bw} días",
            hovertemplate=(
                "Día del año: %{x:.1f}<br>"
                "Intensidad: %{y:.6f}"
                f"<extra>b={bw} días</extra>"
            )
        )
    )

fig.update_layout(
    title=dict(
        text=(
            "Semi-Implícito Compensado: "
            "sensibilidad del suavizado de intensidad"
        ),
        x=0.5,
        xanchor="center"
    ),

    xaxis=dict(
        title="Día del año",
        showgrid=True,
        zeroline=False
    ),

    yaxis=dict(
        title=(
            "Intensidad estimada de detecciones "
            "por trayectoria y día"
        ),
        showgrid=True,
        zeroline=False
    ),

    template="plotly_white",

    hovermode="x unified",

    width=900,
    height=550,

    legend=dict(
        orientation="h",
        yanchor="bottom",
        y=1.02,
        xanchor="right",
        x=1
    ),

    margin=dict(
        l=90,
        r=70,
        t=150,
        b=100
    )
)

fig.show()
Figura 8.12: Sensibilidad de la intensidad estimada de detecciones respecto al ancho de banda para el esquema Semi-Implícito Compensado.

En la realización Monte Carlo estudiada, los índices temporales de detección de ambos esquemas coinciden, por lo que las curvas de intensidad obtenidas a partir de esas detecciones coinciden numéricamente. Esta igualdad es una propiedad de esta ejecución y no una propiedad teórica general de los dos esquemas.

8.6.8 Diagnóstico mediante el cambio de tiempo

Sea \(\Lambda\) el compensador verdadero del proceso de detecciones. El teorema de cambio de tiempo establece, bajo sus hipótesis de regularidad, que los incrementos del tiempo transformado construidos con el compensador verdadero presentan distribución Exponencial de parámetro uno (Brown et al. 2002).

En el análisis computacional, sin embargo, el compensador se estima a partir de las mismas detecciones. El programa calcula

\[\widehat{\Delta S}_k = \widehat{\Lambda}(\tau_k) - \widehat{\Lambda}(\tau_{k-1}), \tag{8.19}\]

y posteriormente

\[V_k = 1-\exp\left(-\widehat{\Delta S}_k\right). \tag{8.20}\]

Si el modelo estuviera correctamente especificado y el compensador verdadero fuera conocido, la transformación produciría variables Uniforme\((0,1)\). En el presente experimento \(\widehat{\Lambda}\) es estimado de las propias detecciones; por ello, el estadístico

\[D_{\mathrm{TR},q} = \sup_{u\in[0,1]} \left| \widehat F_{V,q}(u)-u \right| \tag{8.21}\]

se utiliza únicamente como diagnóstico de cambio de tiempo.

Diagnóstico basado en residuos de cambio de tiempo.
Diagnóstico Milstein compensado Semi-Implícito compensado
Número de residuos 673 673
Media de \(V_k\) 0.464129 0.464129
Mediana de \(V_k\) 0.459566 0.459566
\(D_{\mathrm{TR}}\) 0.076027 0.076027

La igualdad observada en esta ejecución deriva de la coincidencia de las detecciones temporales entre ambos esquemas.

8.6.9 Comparación integrada de los resultados

Comparación integrada de las distribuciones de severidad y tiempos entre detecciones.
Resultado Milstein compensado Semi-Implícito compensado
Detecciones válidas 1,422 1,422
Media de severidad (USD) 1,792,982.74 1,793,024.23
Mediana de severidad (USD) 1,513,050.23 1,513,140.12
Familia paramétrica auxiliar de severidad con menor AIC Lognormal Lognormal
Gaps completos 673 673
Censuras terminales 749 749
Media del gap (días) 196.5973 196.5973
Mediana del gap (días) 147 147
\(CV^2\) 0.677208 0.677208
Familia temporal con menor AIC Exponencial Exponencial
\(D_{\mathrm{TR}}\) 0.076027 0.076027

Los resultados muestran que, para esta realización, ambos esquemas producen exactamente el mismo número de detecciones y la misma estructura temporal de detecciones, mientras que las severidades agregadas presentan diferencias numéricas muy pequeñas. La diferencia relativa de las medias de severidad es aproximadamente \(0.00231 \%\), y la diferencia relativa de las medianas es aproximadamente \(0.00594 \%\). Asimismo, los ajustes paramétricos auxiliares presentan valores de AIC prácticamente coincidentes entre ambos métodos.

La coincidencia de los resultados temporales no debe confundirse con una equivalencia teórica de los esquemas numéricos. La inferencia aquí presentada es condicional a la realización Monte Carlo concreta y a la configuración del detector \((\alpha,\varpi)=(3.5,0.45)\).

La interpretación estadística de los resultados se sustenta en el marco desarrollado en las Secciones 6.4.2 y 6.4.3 y en las referencias bibliográficas de la tesis: detección no paramétrica de saltos (Mancini 2009; Lee y Mykland 2008,), variación bipotencia (Barndorff-Nielsen y Shephard 2004), estimación de densidad mediante núcleos (Silverman 1986), procesos de conteo y análisis de supervivencia (Aalen 1978; Andersen et al. 1993), estimación de intensidades mediante funciones núcleo (Ramlau-Hansen 1983), tratamiento de censura (Kaplan y Meier 1958), criterio de información de Akaike (Akaike 1974), bootstrap (Efron y Tibshirani 1993) y cambio de tiempo para procesos de eventos (Brown et al. 2002).

8.7 Implicaciones para la Gestión de Riesgos en el Contexto de la CDMX

Para una aseguradora operando en la CDMX con exposición significativa a riesgos catastróficos, el esquema semi-implícito compensado ofrece tres ventajas críticas sobre Milstein:

  1. Conservadurismo alineado con prudencia regulatoria: El \(+2.30\%\) adicional en la reserva mediana y el \(+1.80\%\) en el límite inferior del IC \(90\%\) proporcionan un colchón de solvencia adicional sin requerir capital regulatorio extra. Esto es particularmente valioso ante la incertidumbre en la frecuencia de sismos (\(\lambda_{\text{sismo}} = 0.15\) eventos/año en la simulación vs. \(0.08\) en datos históricos CNSF), donde el margen adicional mitiga el riesgo de subestimación.

  2. Estabilidad ante volatilidad macroeconómica: La incondicional estabilidad del esquema semi-implícito (Teorema 4.2 en Higham et al. (2002)) garantiza convergencia incluso ante shocks en \(r(t)\), como los observados durante la política monetaria restrictiva de Banxico (2023-2024). En contraste, el esquema de Milstein requiere \(\Delta t < 2/r_{\max}\) para estabilidad, limitando su aplicabilidad en escenarios de alta inflación.

  3. Eficiencia computacional para horizontes extendidos: Para simulaciones a \(5\) años (\(T=5\)), el esquema semi-implícito permite aumentar \(\Delta t\) a \(1/12\) (mensual) sin pérdida de estabilidad, reduciendo el costo computacional en un \(96.7\%\) (\(365 \to 12\) pasos/año) mientras mantiene errores relativos \(< 0.5\%\) en la mediana. Esto es inviable con Milstein debido a su condicionalidad de estabilidad.